4-hi HBM:少即是多的内存革命
HBM技术的革命性转变
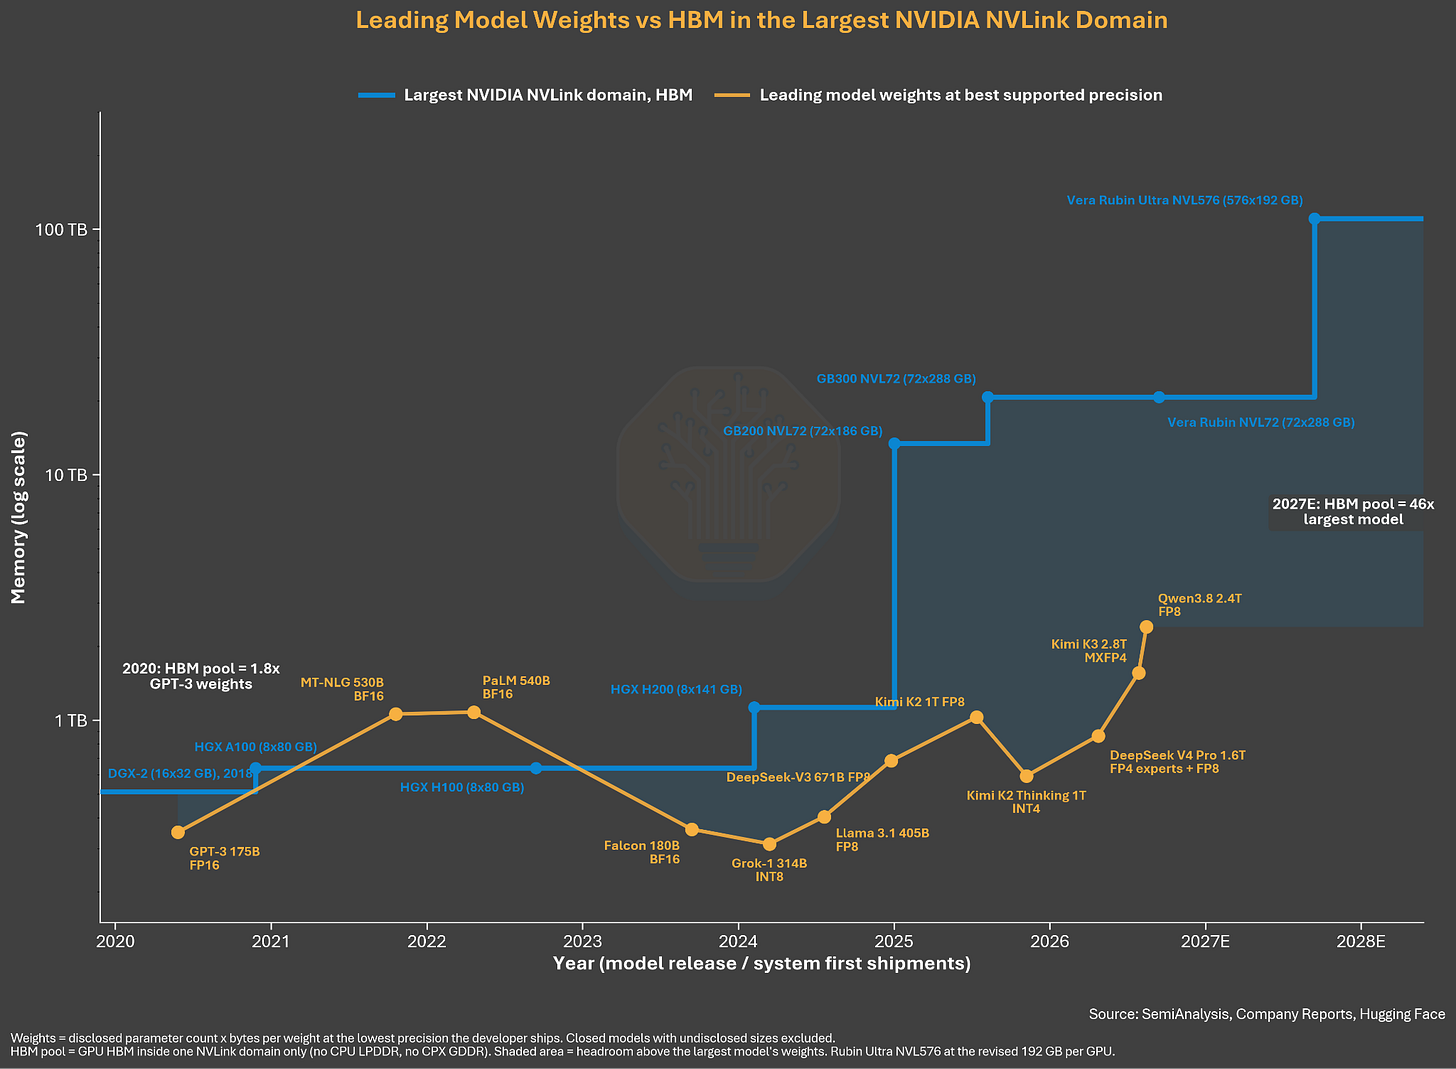
高带宽内存(HBM)已成为推动AI革命的关键技术。尽管HBM与其他形式内存相比成本较高,但芯片设计者仍不断在AI加速器中集成更多HBM。客户不仅追求更新一代的HBM,还通过增加更多芯片堆叠、更高密度和更高堆叠来提升每个XPU的容量。这一趋势导致HBM占DRAM晶圆总容量的比例持续增加,从而引发了当前我们所经历的极端DRAM短缺问题。
行业趋势的转向
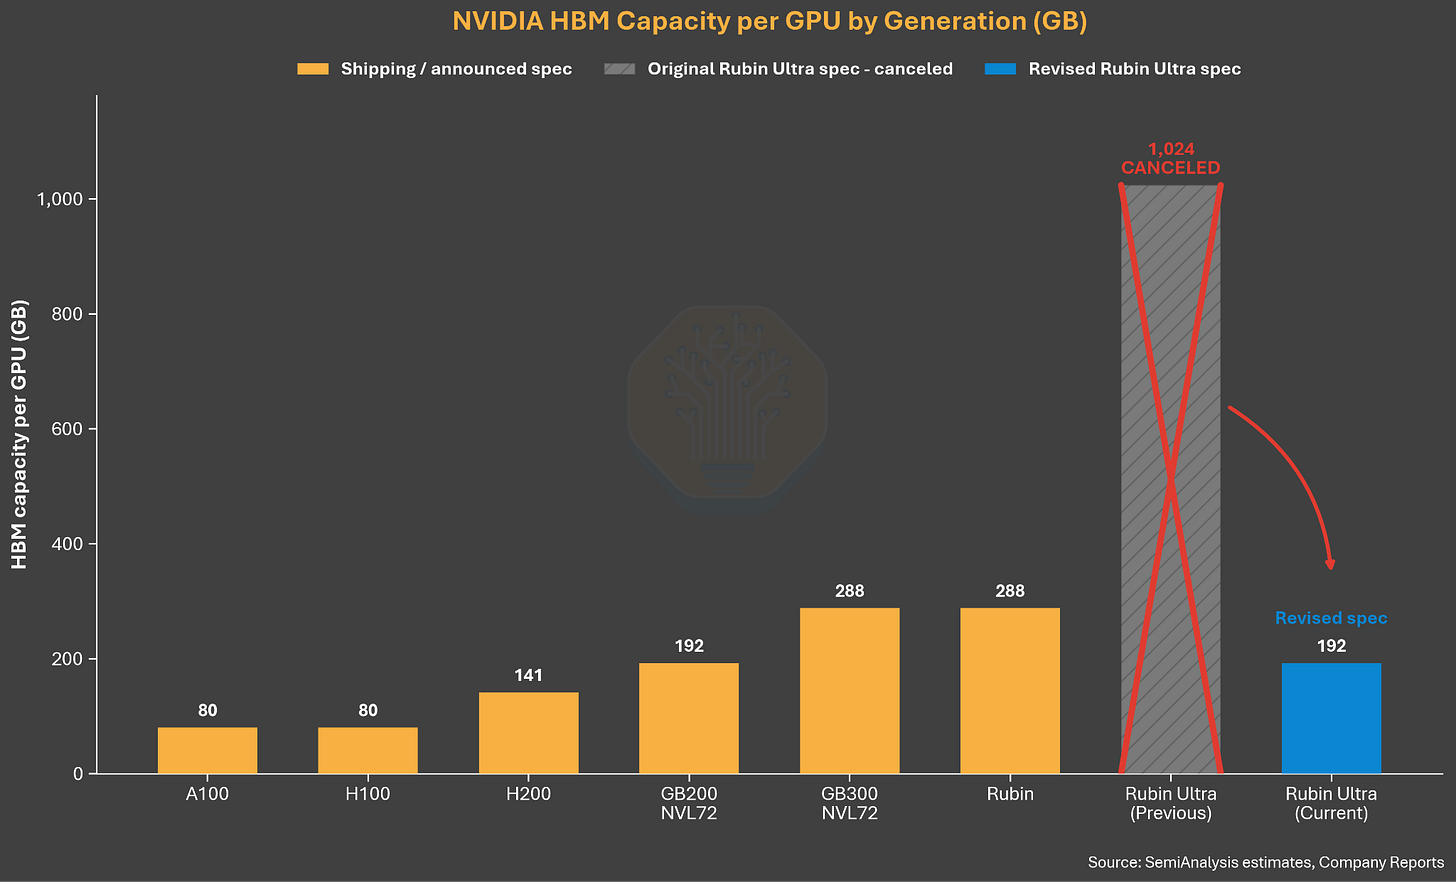
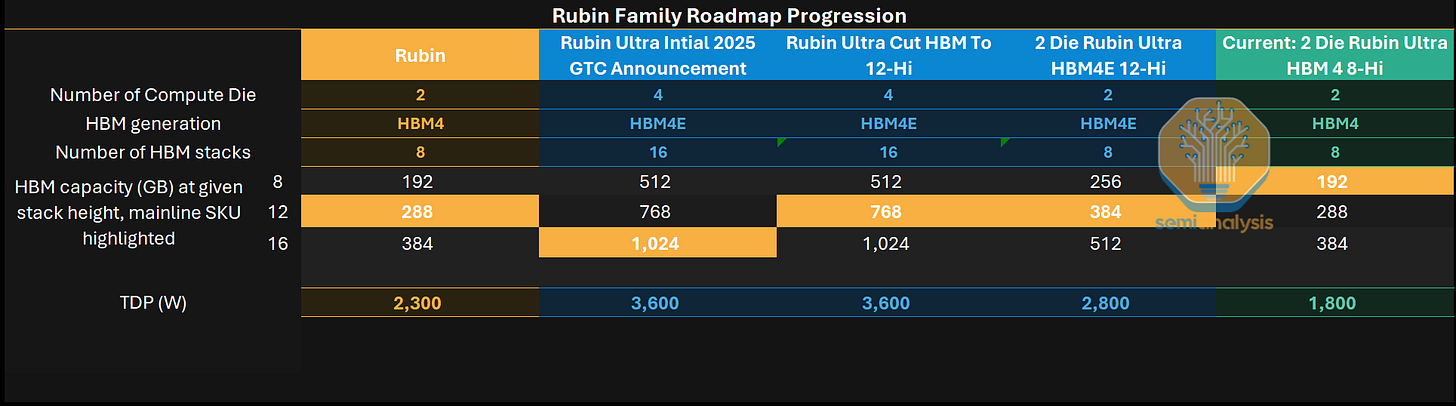
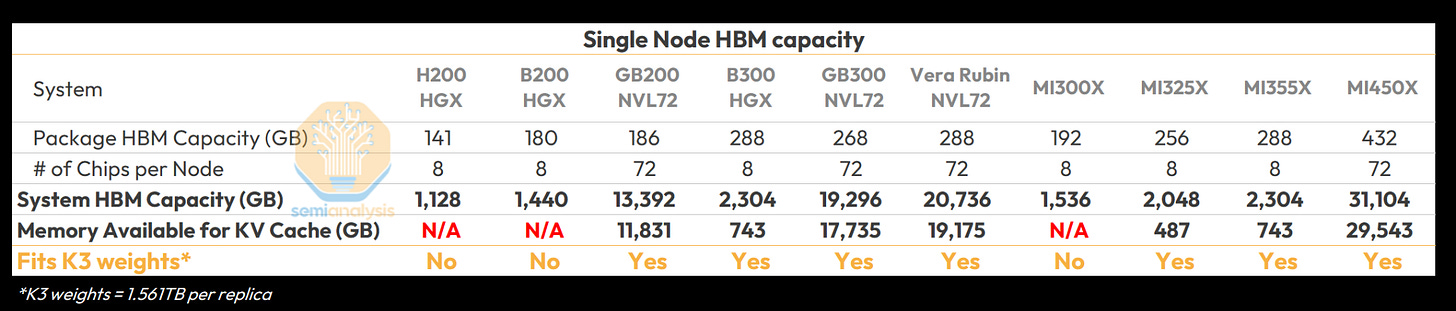
如今,这一趋势即将迎来转折点,原因既有技术层面的,也有供应链驱动的因素。下一代加速器正以8层堆叠(8-hi)为标准,而当前行业标准是12层堆叠(12-hi)。Nvidia决定在其Rubin Ultra产品中采用这一转变,将每个GPU的容量从288GB降至192GB,相比标准的Rubin和B300有所降低。供应链现在正准备将8-hi作为新标准,而就在不到一年前,行业还在预期会发展到16层堆叠甚至更高。
4-hi HBM的崛起
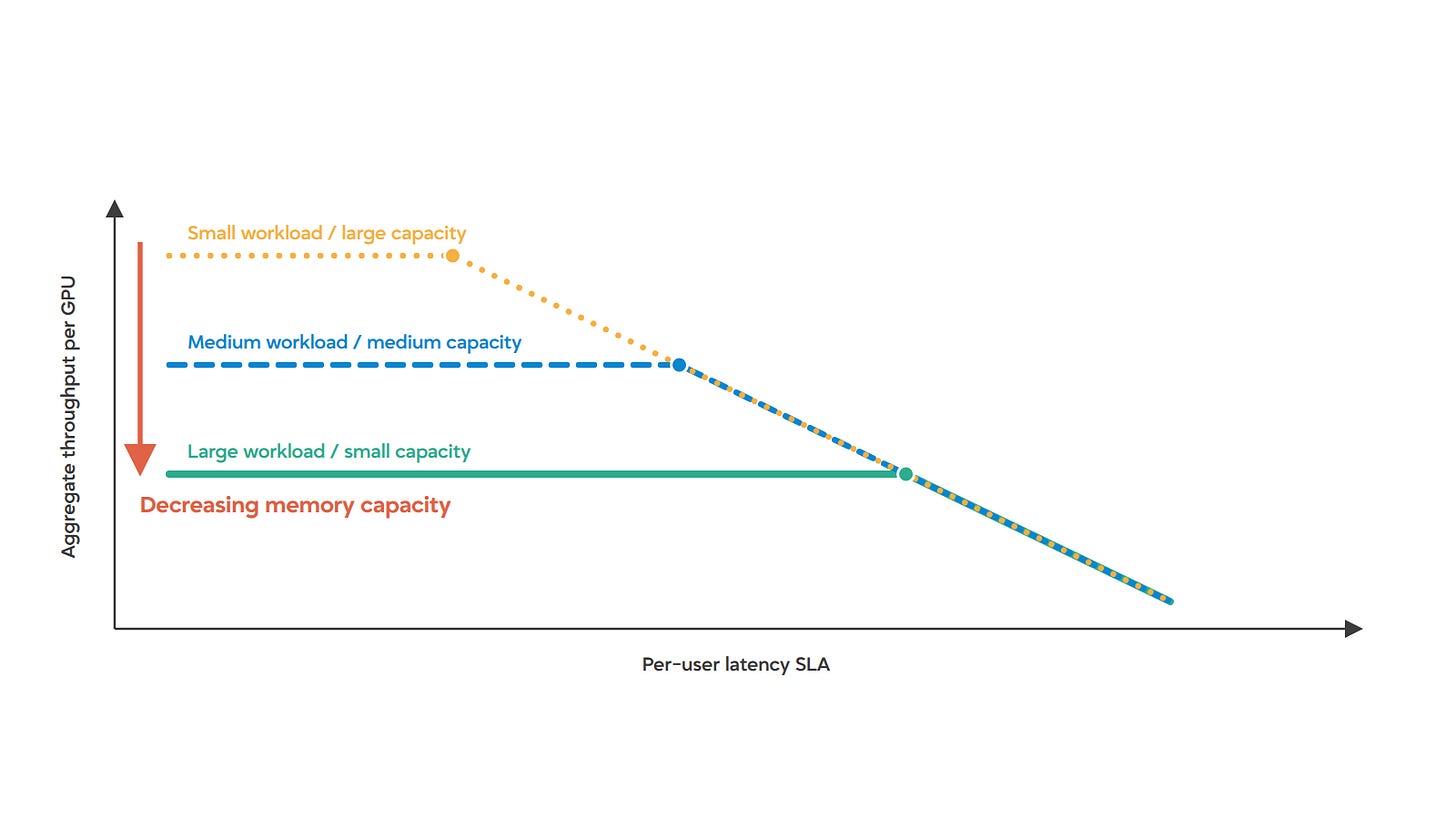
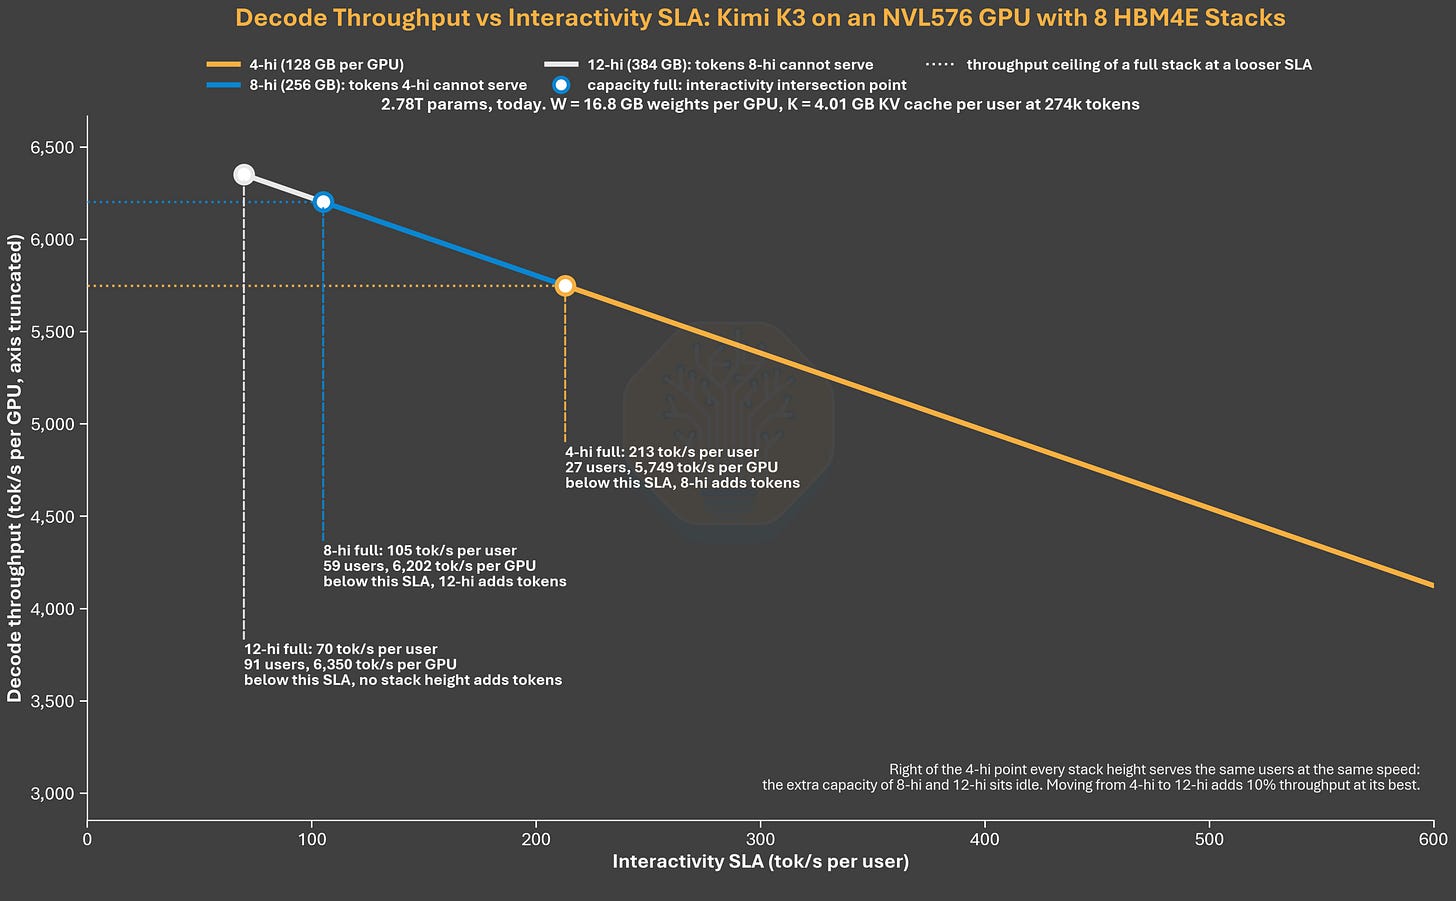
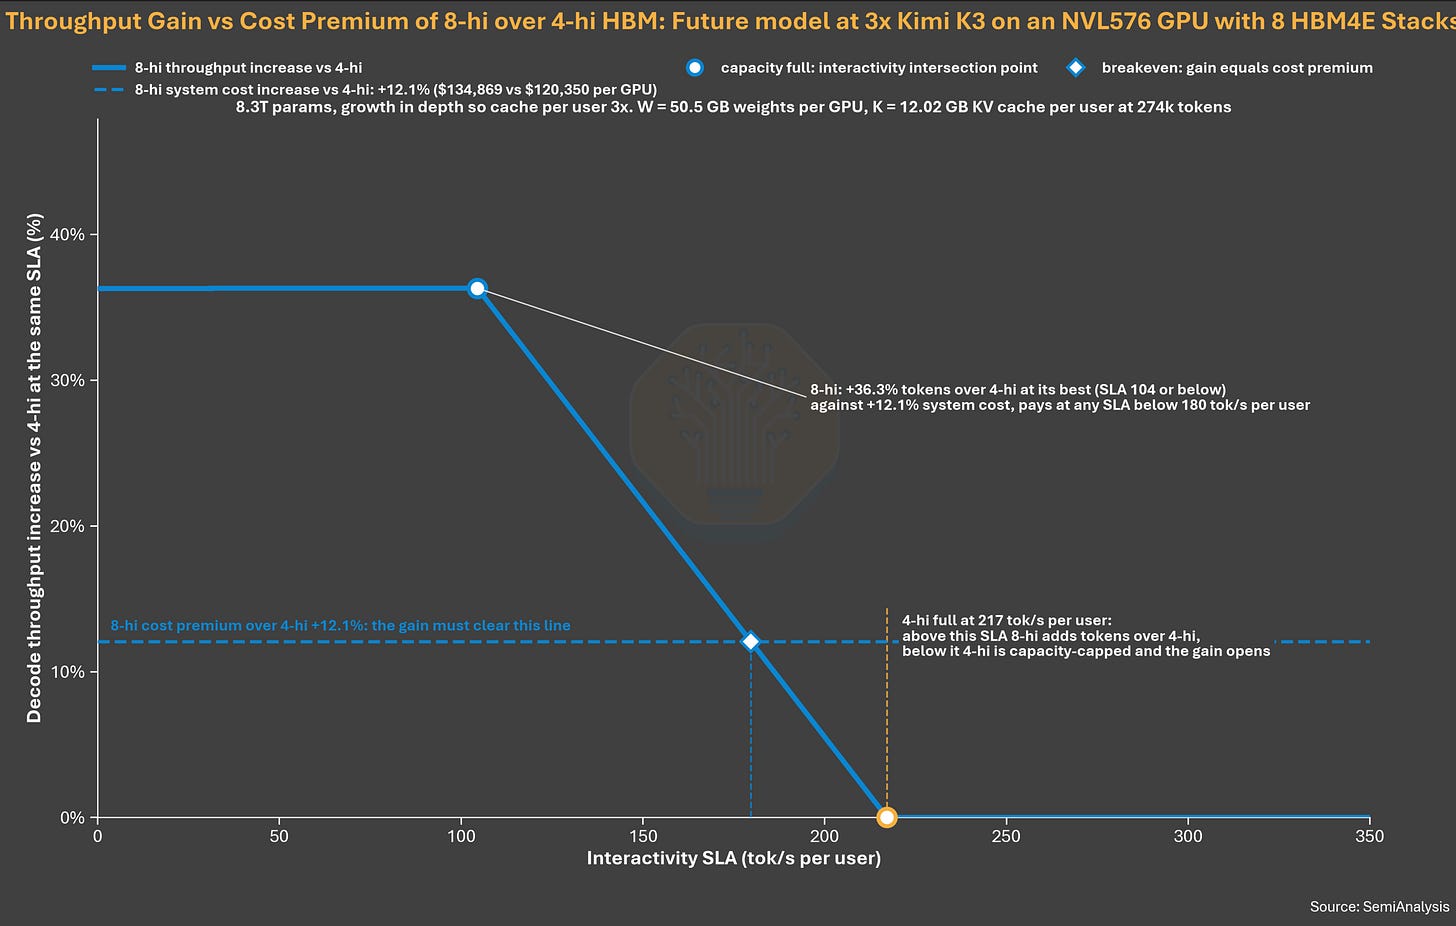
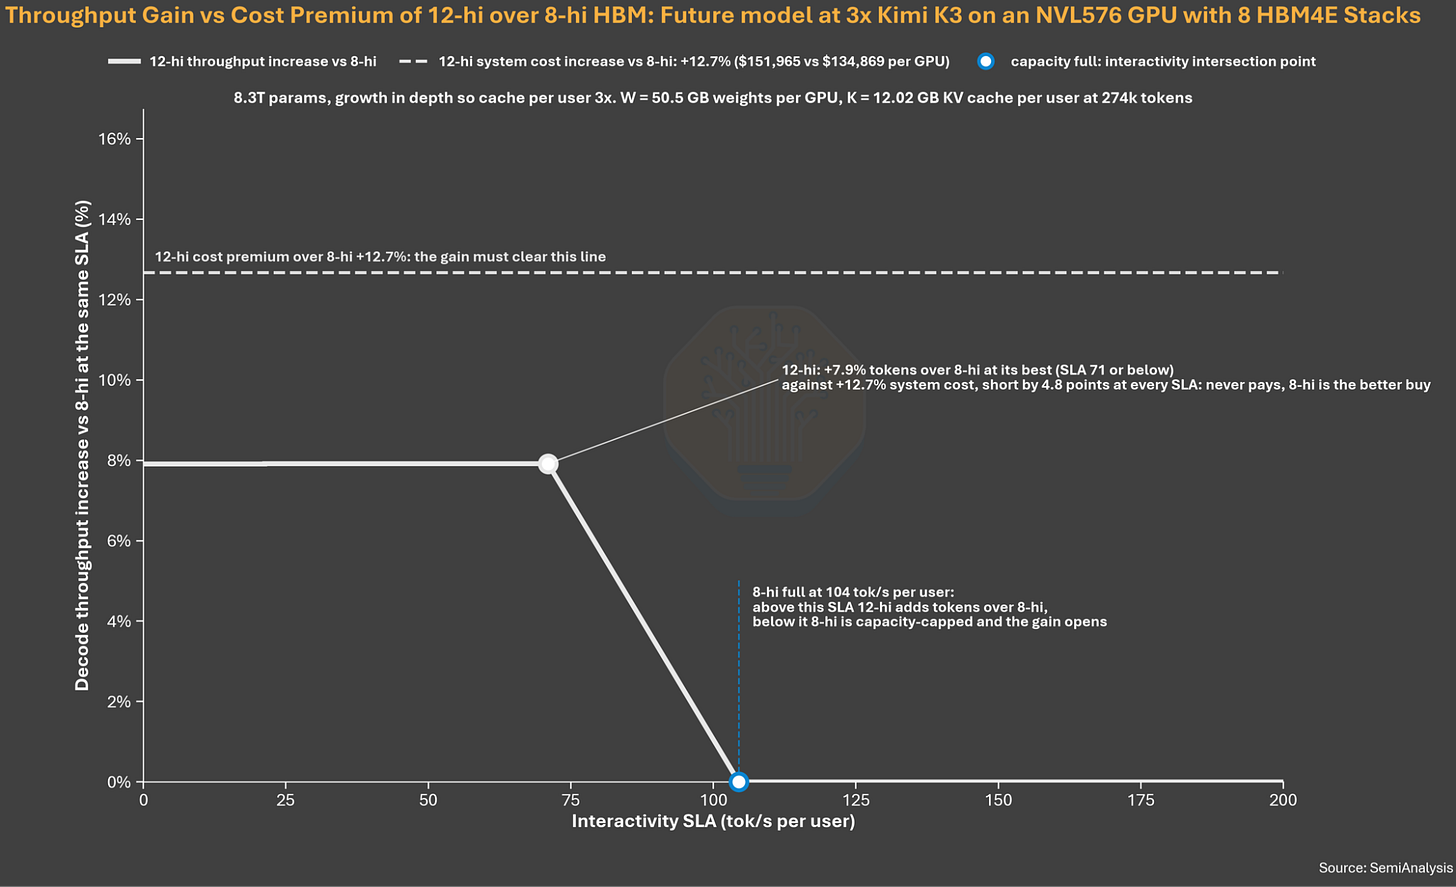
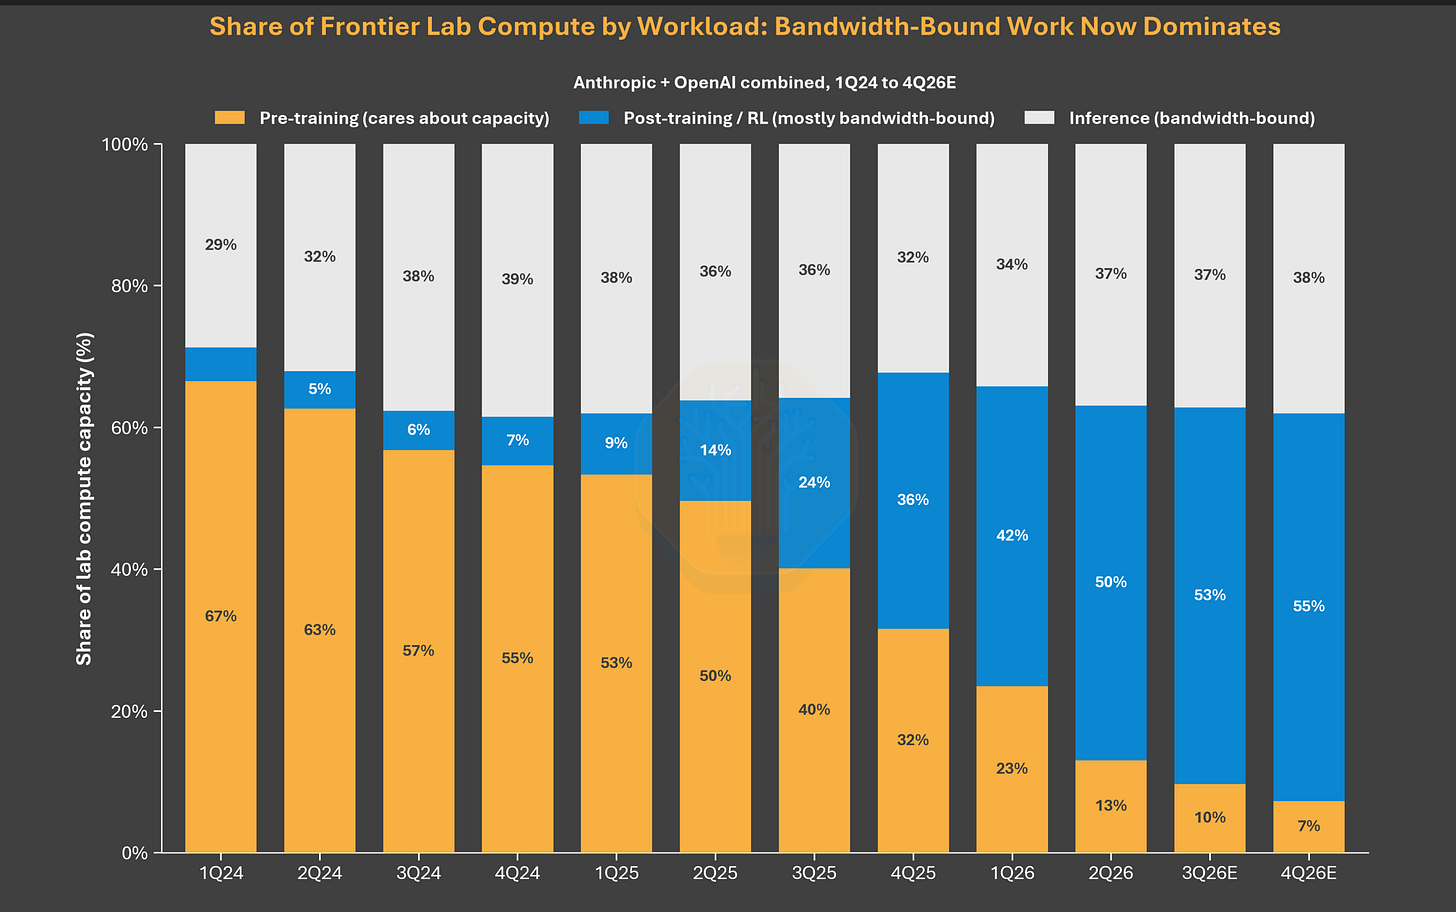
然而,正如我们在《内存模型》报告中所述,这一趋势将进一步发展。在内存带宽最为关键的推理工作负载中,4-hi HBM提供了最佳的带宽成本比,从而实现最低的每个token成本。容量在达到特定阈值之前是重要的,超过该点后,更多的HBM容量带来的收益递减,而这些额外的比特位却带来相同的物料清单(BOM)成本。这正是各大实验室硬件团队希望在下一代HBM4及以后的产品中实现的目标。
正如硬件设计者在直流电源限制环境下专注于最大化每瓦token数一样,4-hi HBM是如何最大化每片HBM晶圆的token数量,这是另一种稀缺资源。
双赢的解决方案
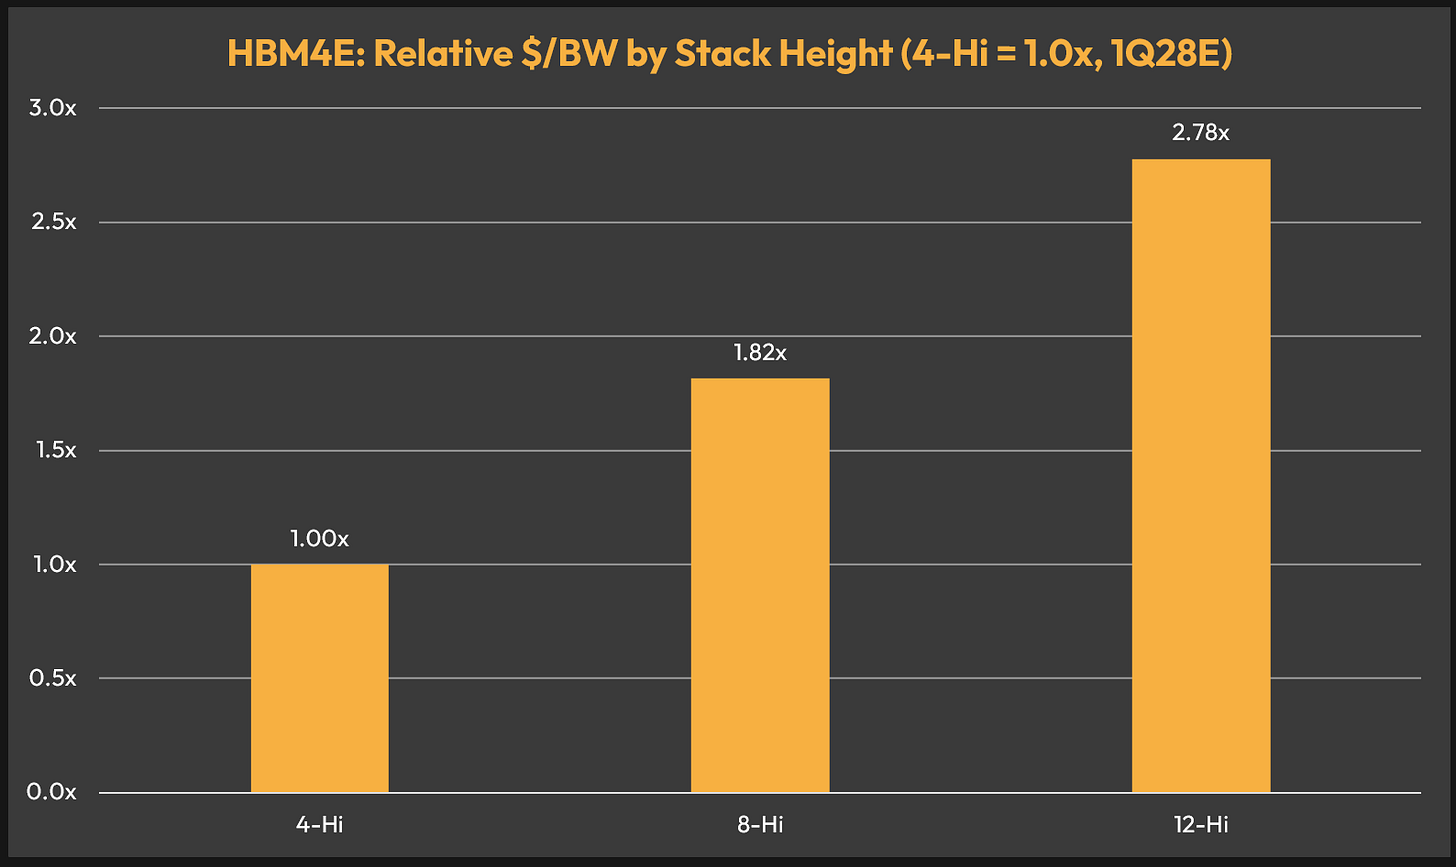
本报告将深入探讨容量方程背后的变化原因,证明HBM容量常常被闲置,以及这如何能成为实验室总成本和内存供应商盈利能力的双赢方案。
关注微信号:智享开源 ,及时了解更新信息。

原文链接:https://newsletter.semianalysis.com/p/long-live-the-short-king-why-4-hi
为你推荐



还没有任何评论,你来说两句吧!