GLM5.3稀疏注意力对内存影响解析
GLM5.3稀疏注意力机制与内存优化
大语言模型推理过程中,内存管理是一个关键挑战。GLM5.3引入的稀疏注意力机制为这一问题提供了新的解决思路。本文将深入探讨稀疏注意力如何影响高带宽内存(HBM)和NAND内存的使用效率。
稀疏注意力的基本原理
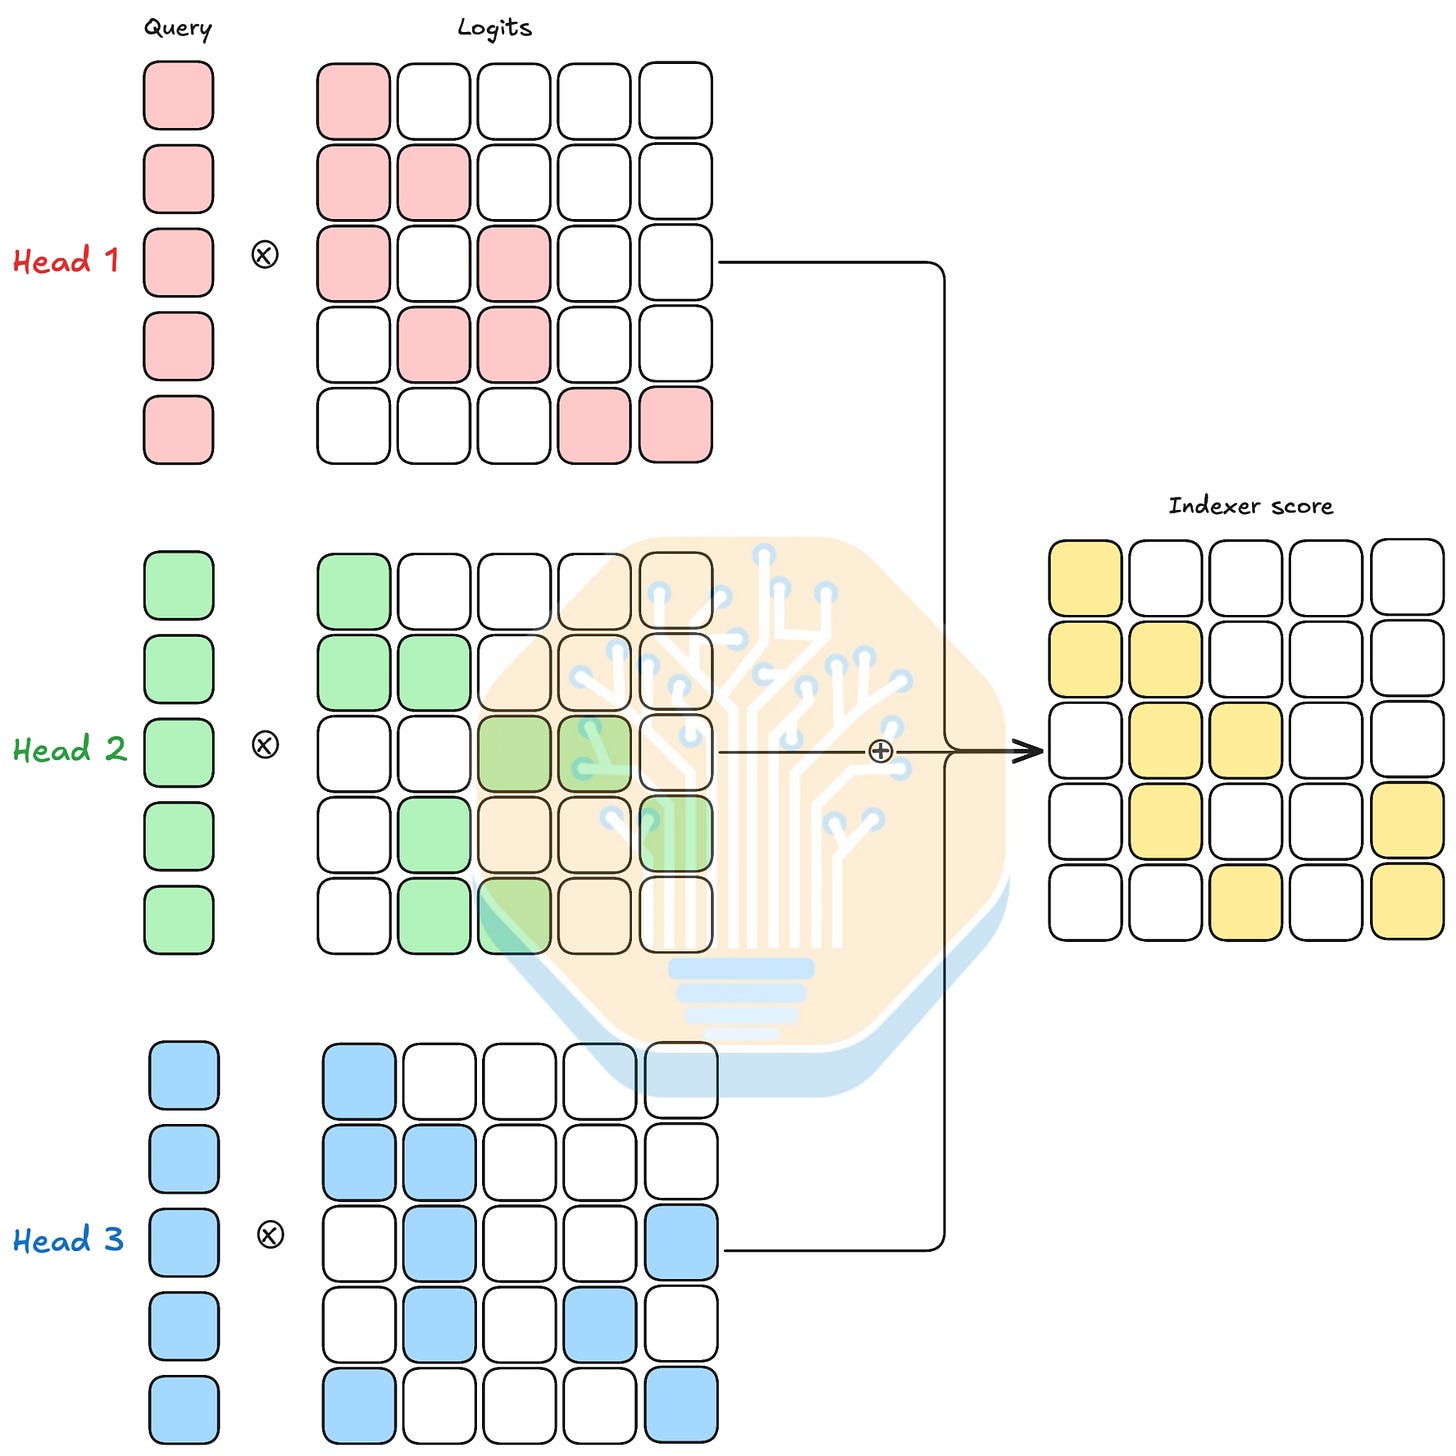
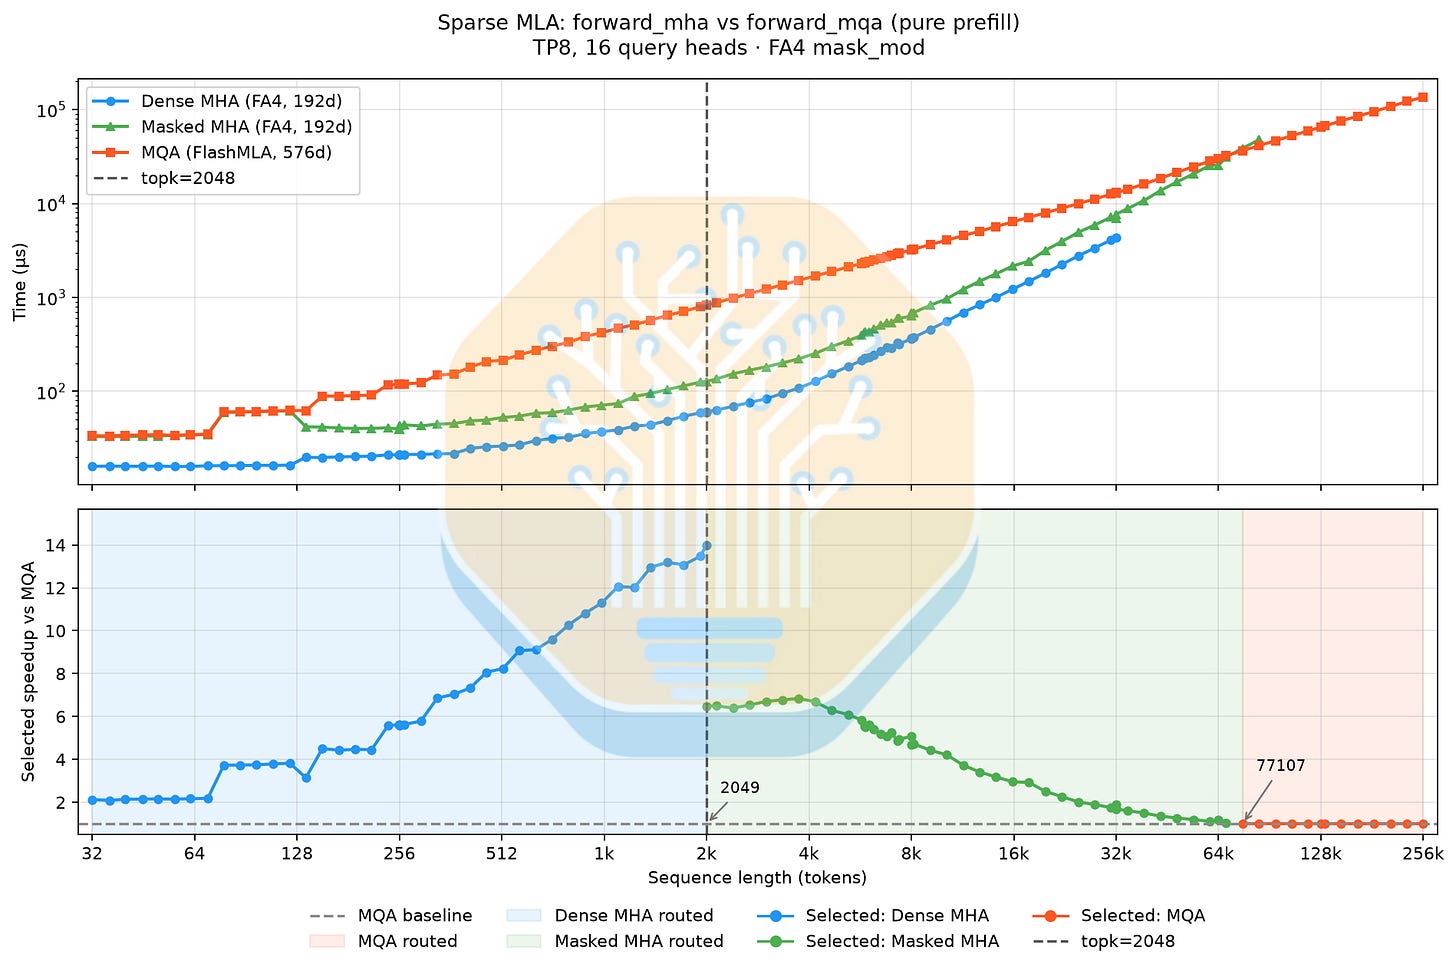
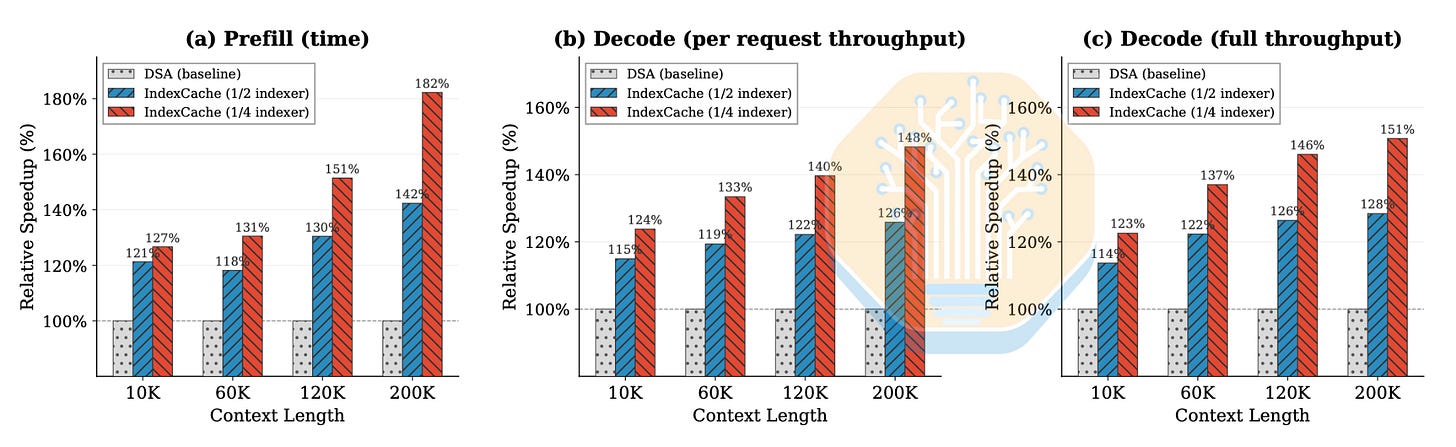
稀疏注意力机制通过智能选择最相关的top-k token,显著降低了核心缩放点积注意力(SDPA)操作过程中的内存消耗与带宽需求。这种选择性关注机制使得模型能够更高效地处理长文本上下文,而不需要计算所有token之间的关系。
理论优势与实践限制
尽管稀疏注意力在理论上能够提高计算效率,但在实际应用中,这种优势并不会直接转化为整体内存使用的减少。关键原因在于,top-k选择操作通常需要将完整的上下文数据存储在HBM中,这意味着稀疏注意力无法从根本上解决内存容量瓶颈问题。
内存优化技术对比
GLM5.3结合了多种内存优化技术,以应对不同的应用场景需求:
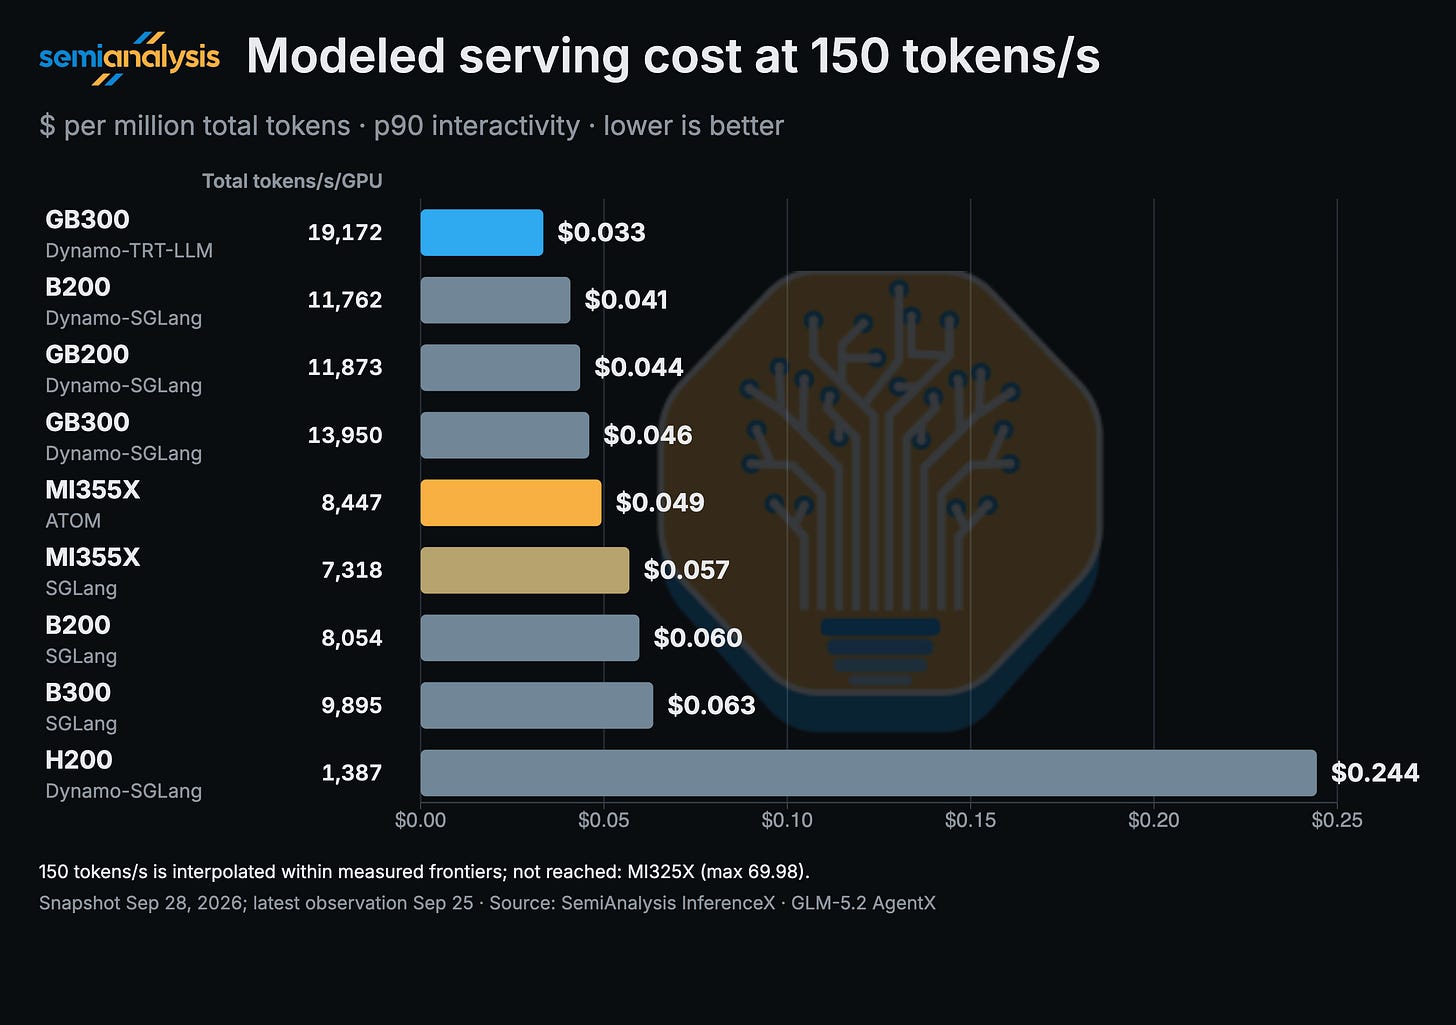
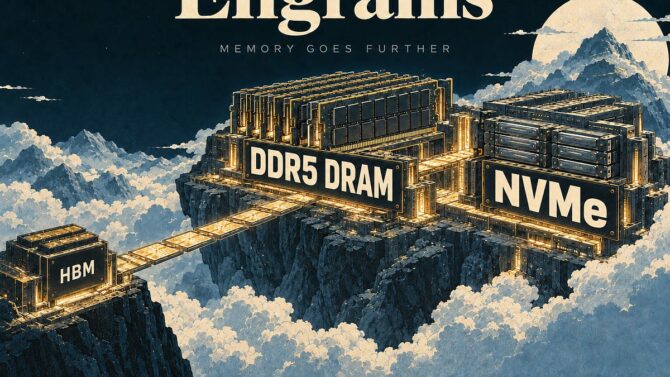
- KV Cache卸载:将键值缓存动态转移到不同存储层级,平衡内存使用与性能
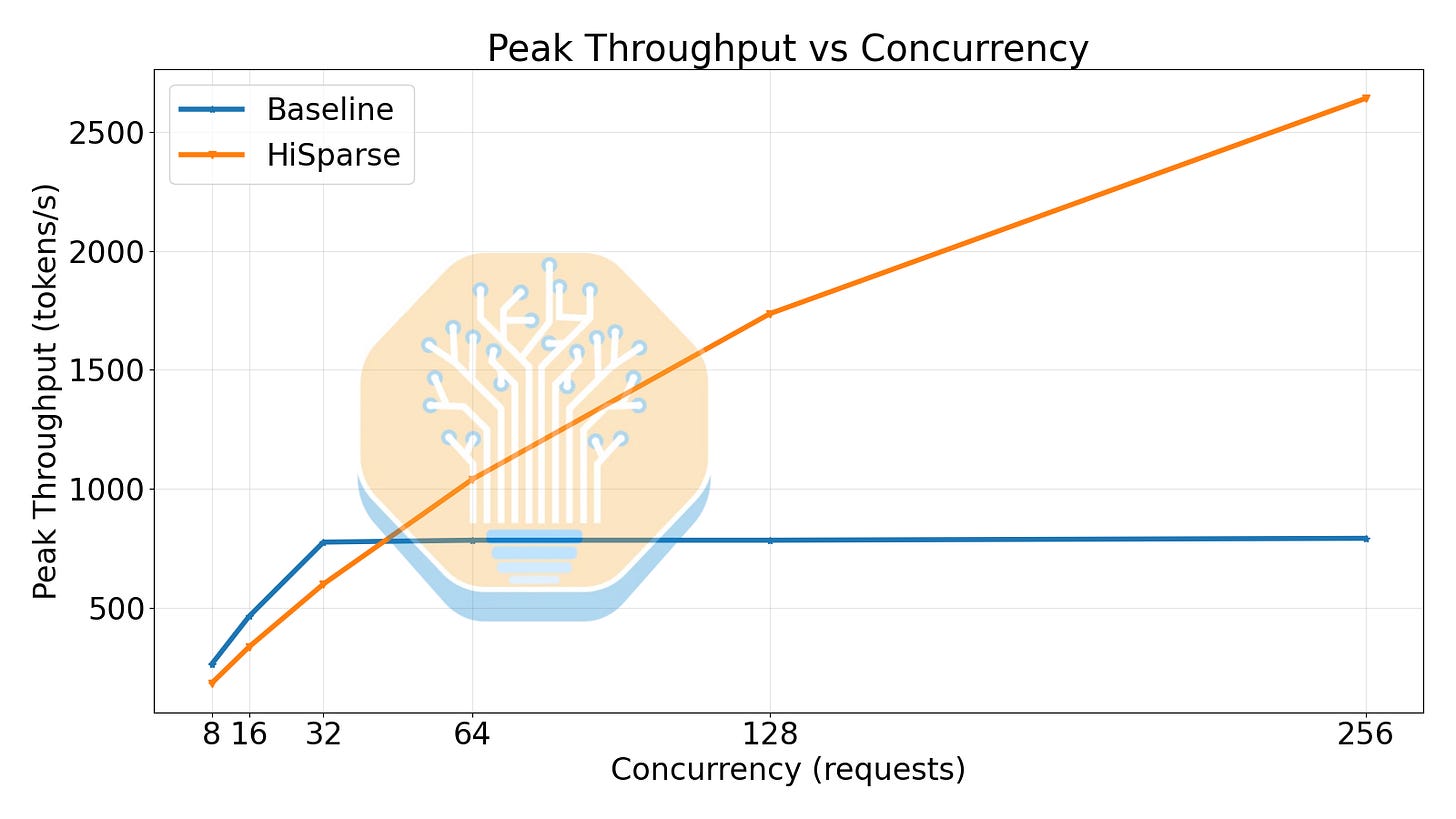
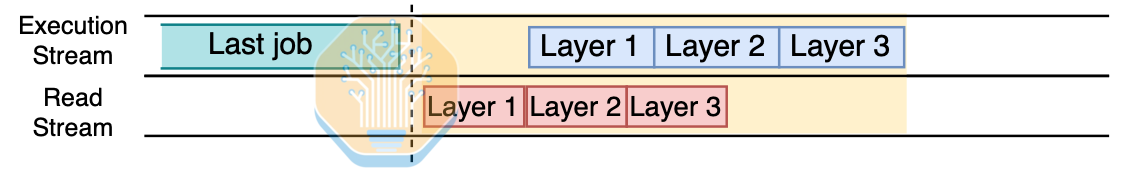
- HiSparse:高效率稀疏矩阵运算,减少不必要计算
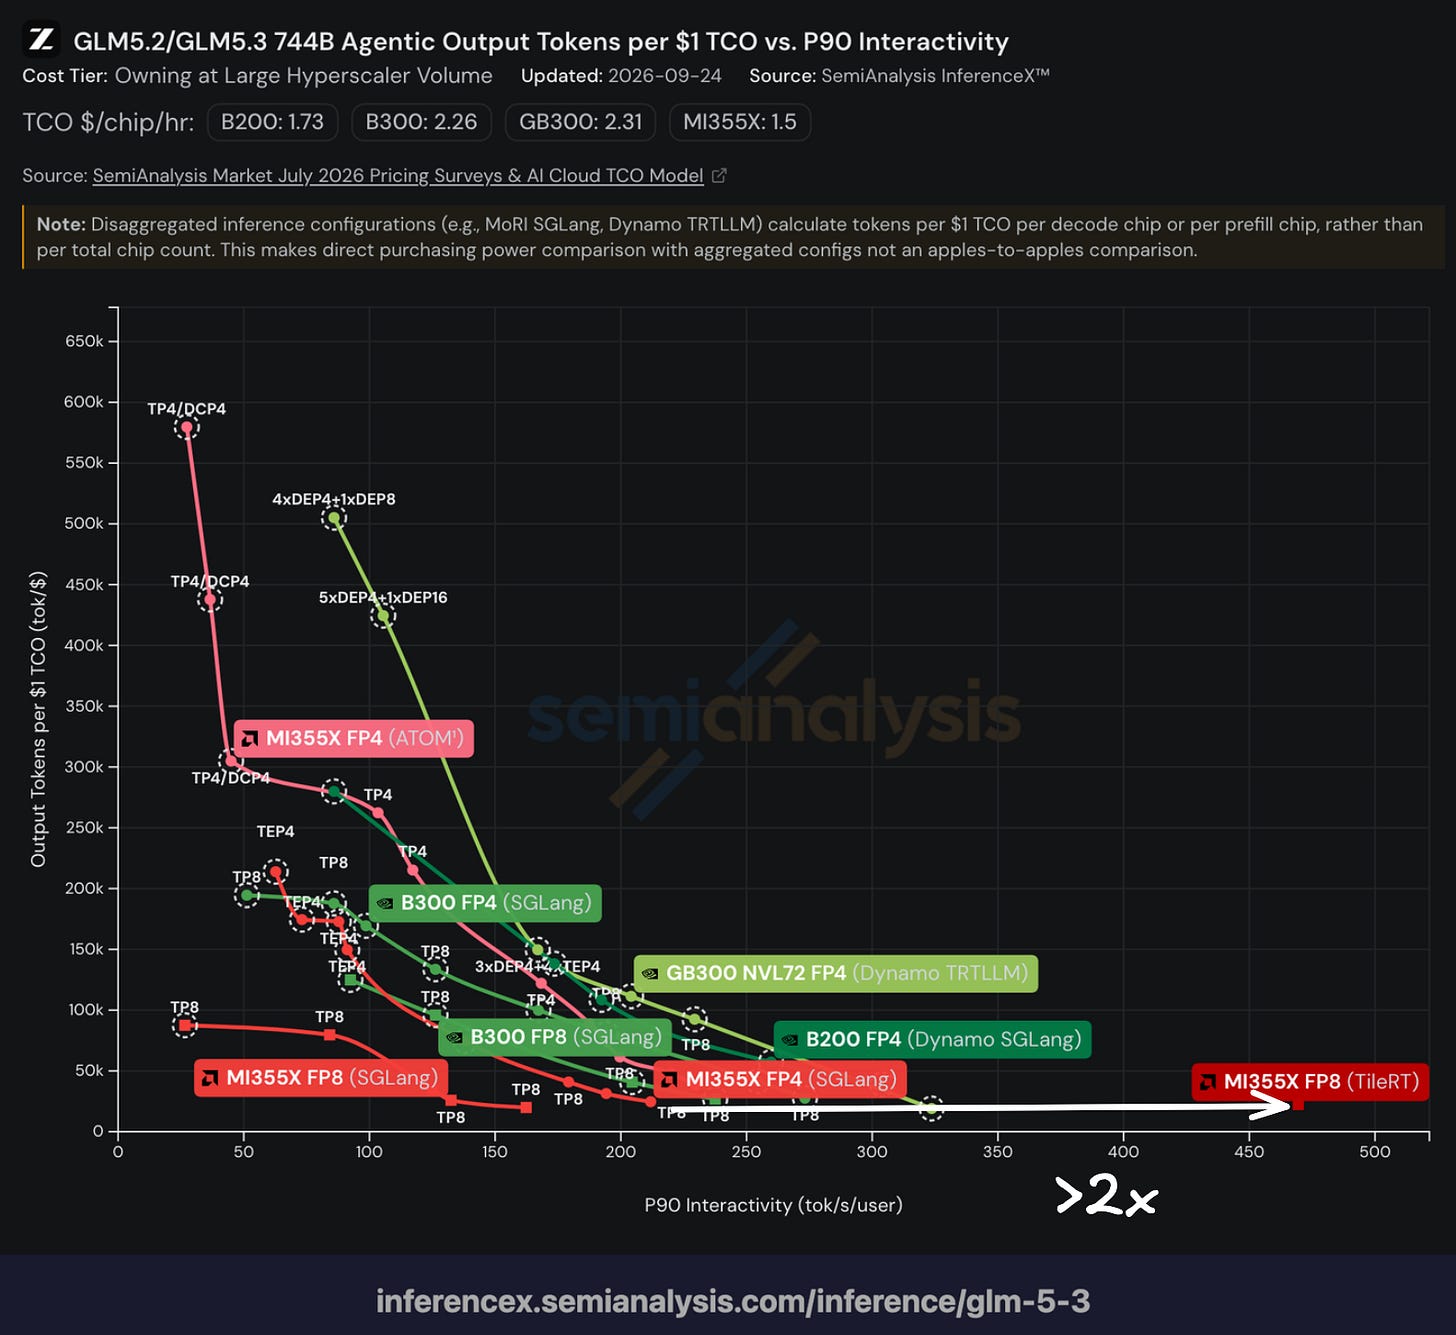
- AgentX TileRT:针对特定任务的实时优化技术
- InferenceX DeepSeek稀疏注意力:专为推理优化的稀疏注意力实现
- IndexShare:索引共享机制,减少重复计算
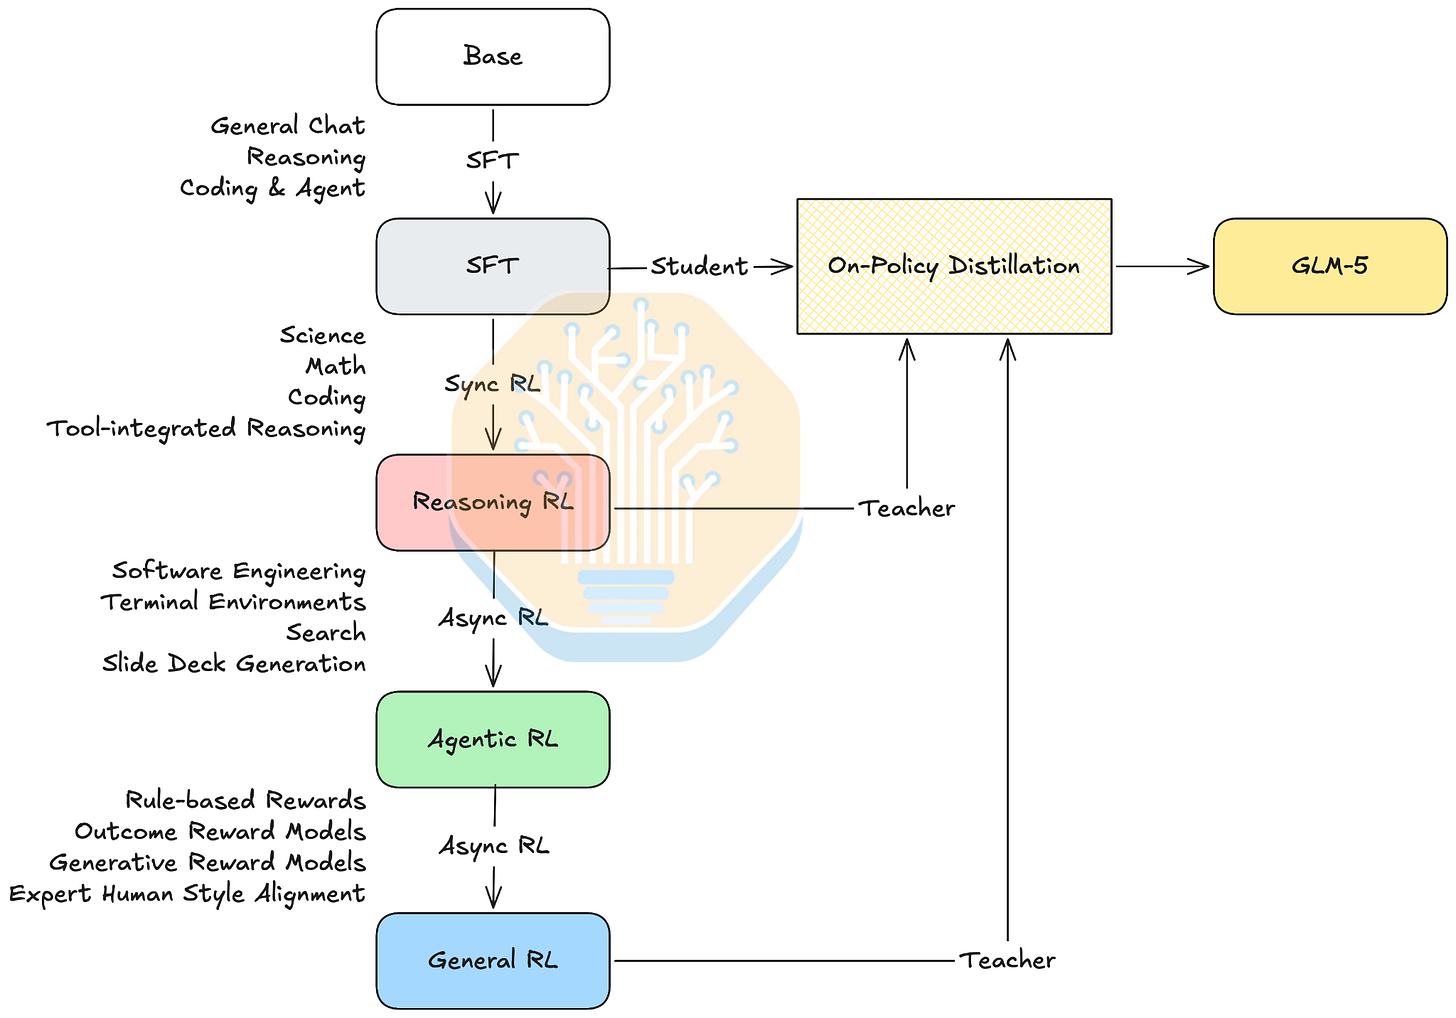
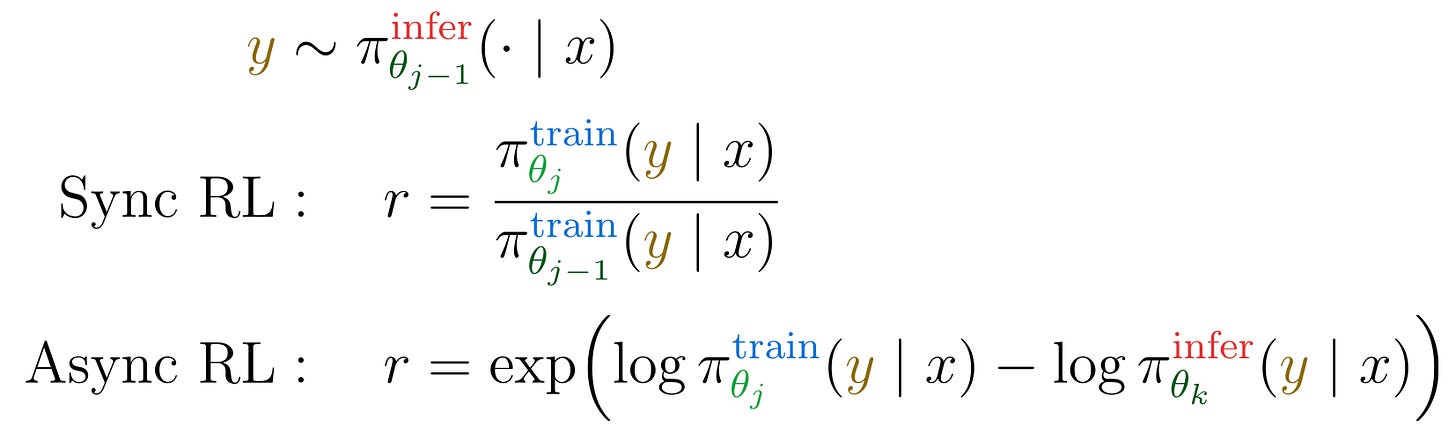
- 单轮次异步优化:提高处理效率,减少等待时间
内存使用趋势分析
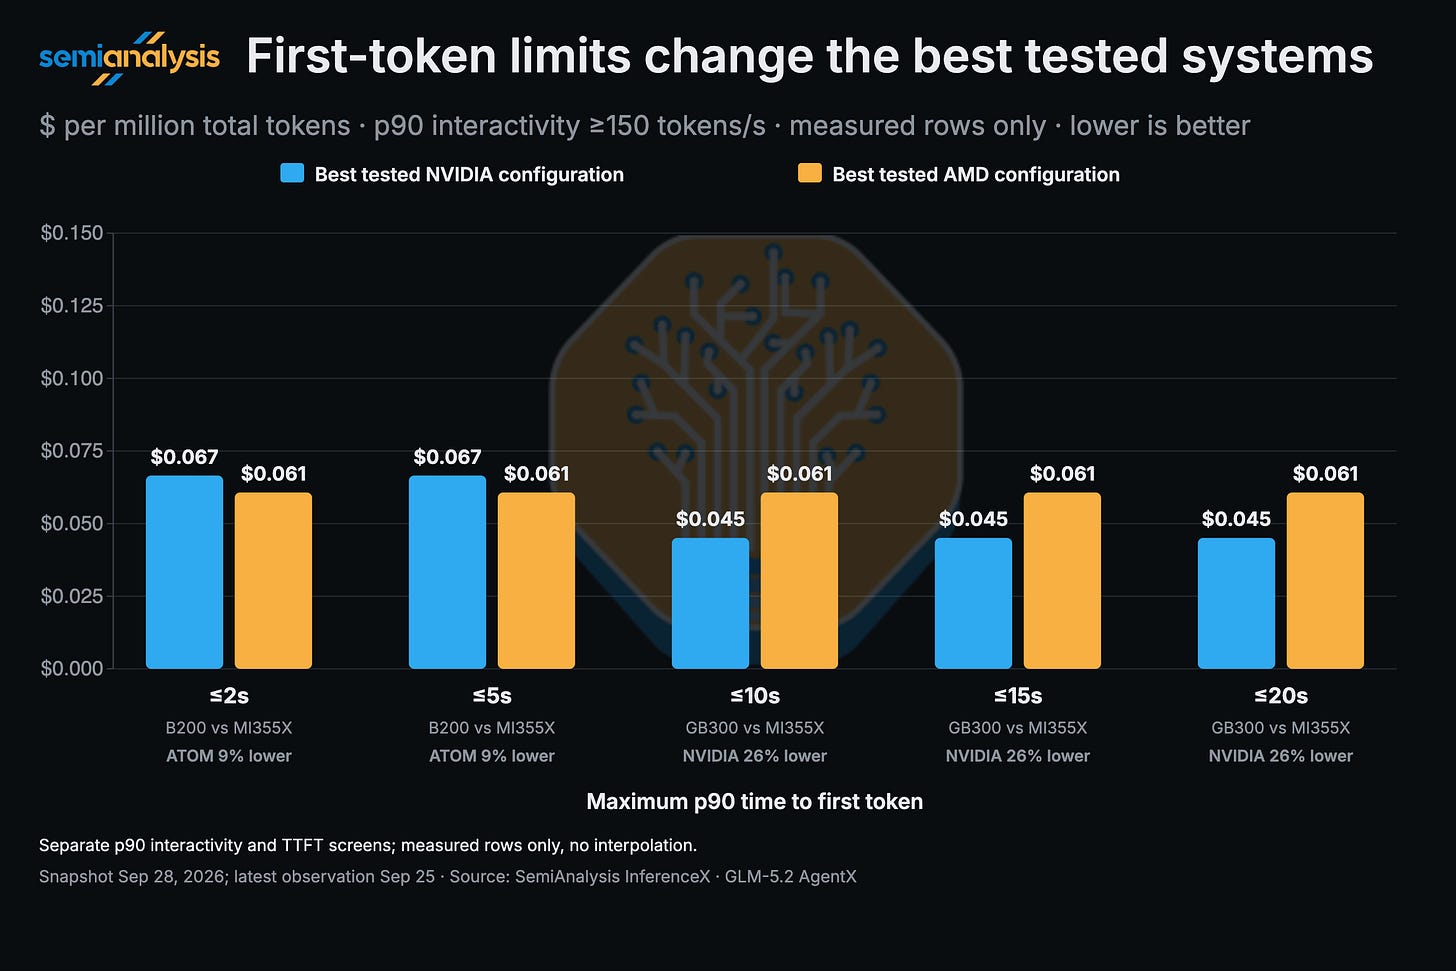
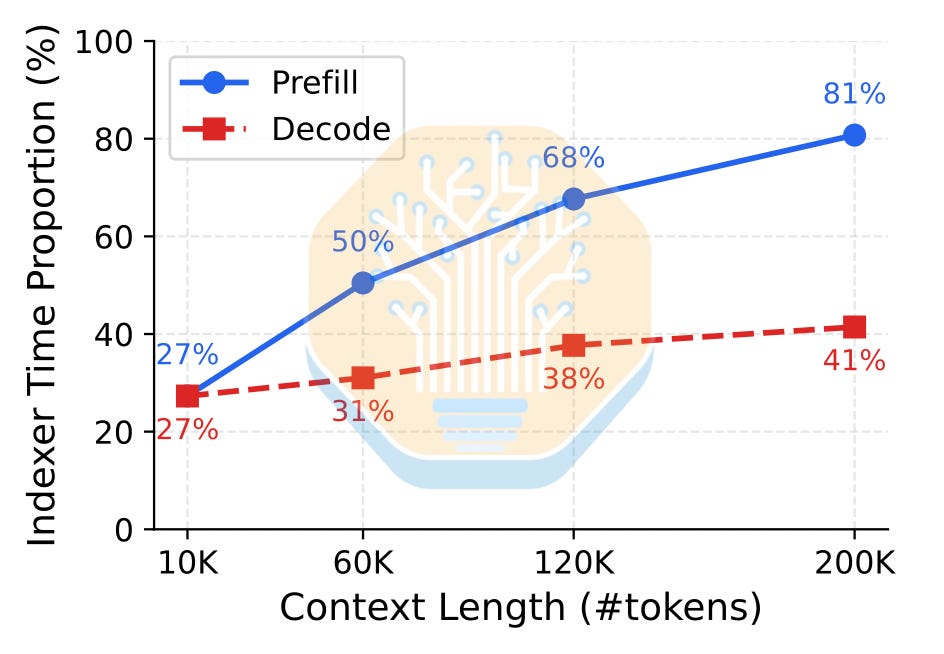
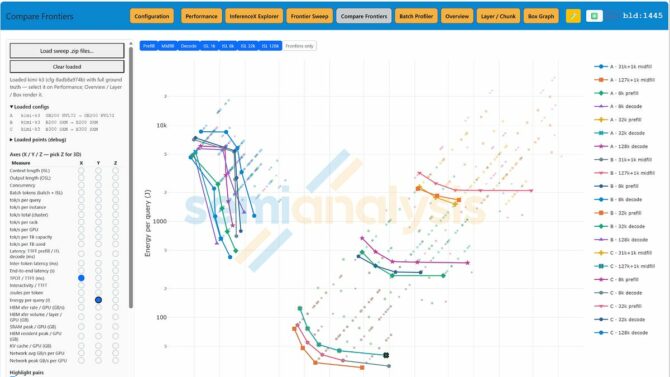
研究表明,尽管稀疏注意力机制减少了SDPA操作中的内存使用,但整体内存需求并未按预期比例下降。这是因为预处理和后处理阶段的内存开销仍然存在,特别是在处理超长上下文时,内存压力主要来自于数据加载和预处理阶段,而非核心注意力计算。
未来发展方向
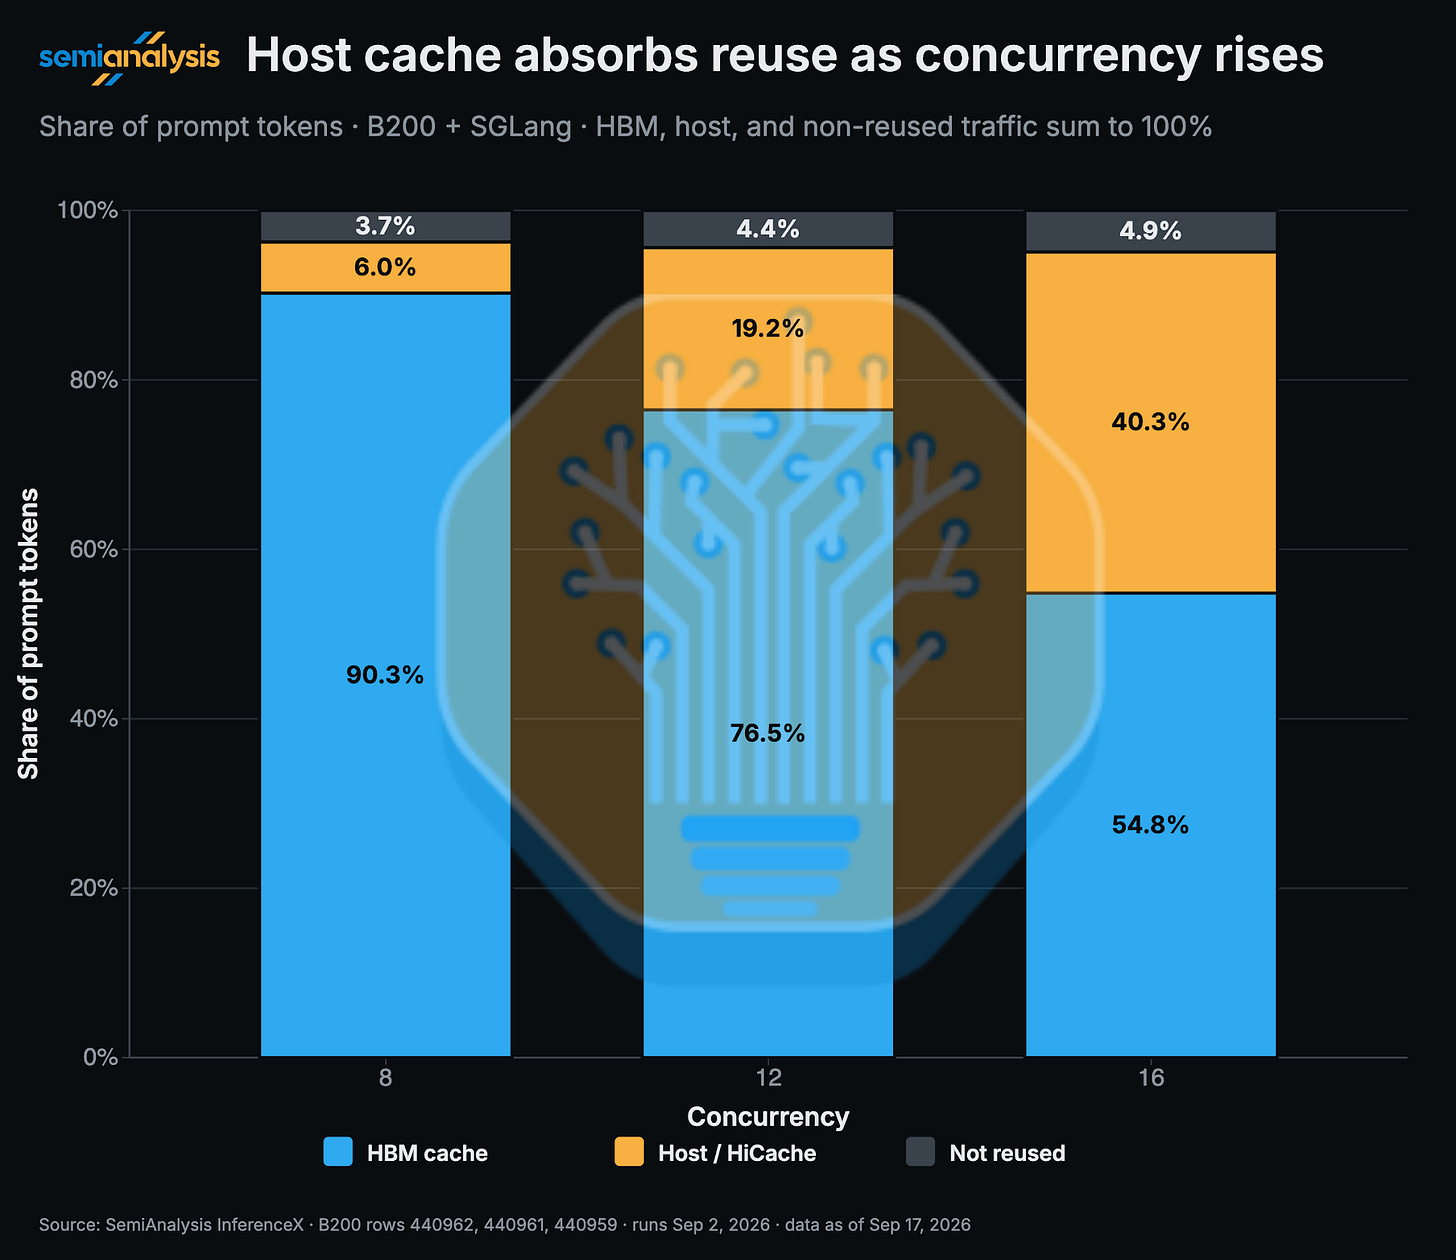
未来的内存优化研究将更加关注全流程的内存管理,而不仅仅是核心计算环节。开发能够智能分配存储资源的技术,结合不同存储层级的特性,可能是解决大模型内存挑战的关键方向。
关注微信号:智享开源,及时了解更新信息。
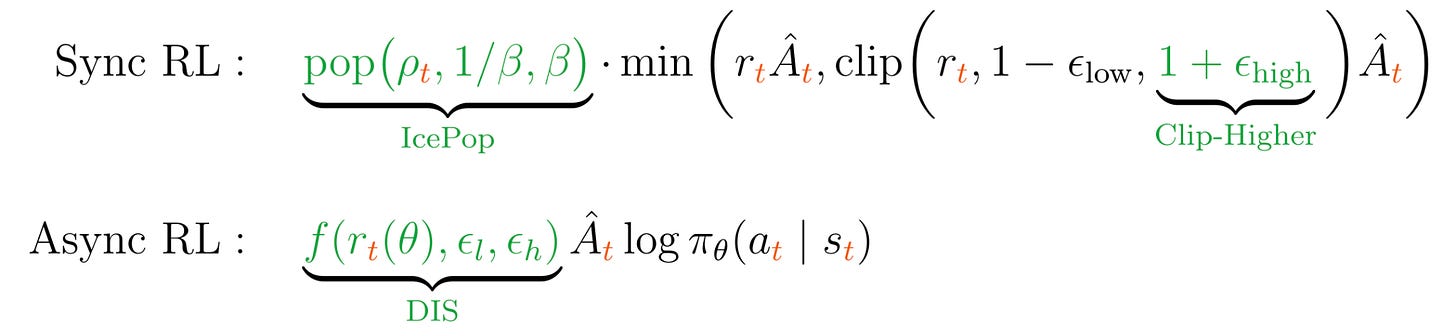

原文链接:https://newsletter.semianalysis.com/p/sparse-savings-persistent-demand-inside-glm53
为你推荐

还没有任何评论,你来说两句吧!