Engram:内存效率的革命性突破
技术概述
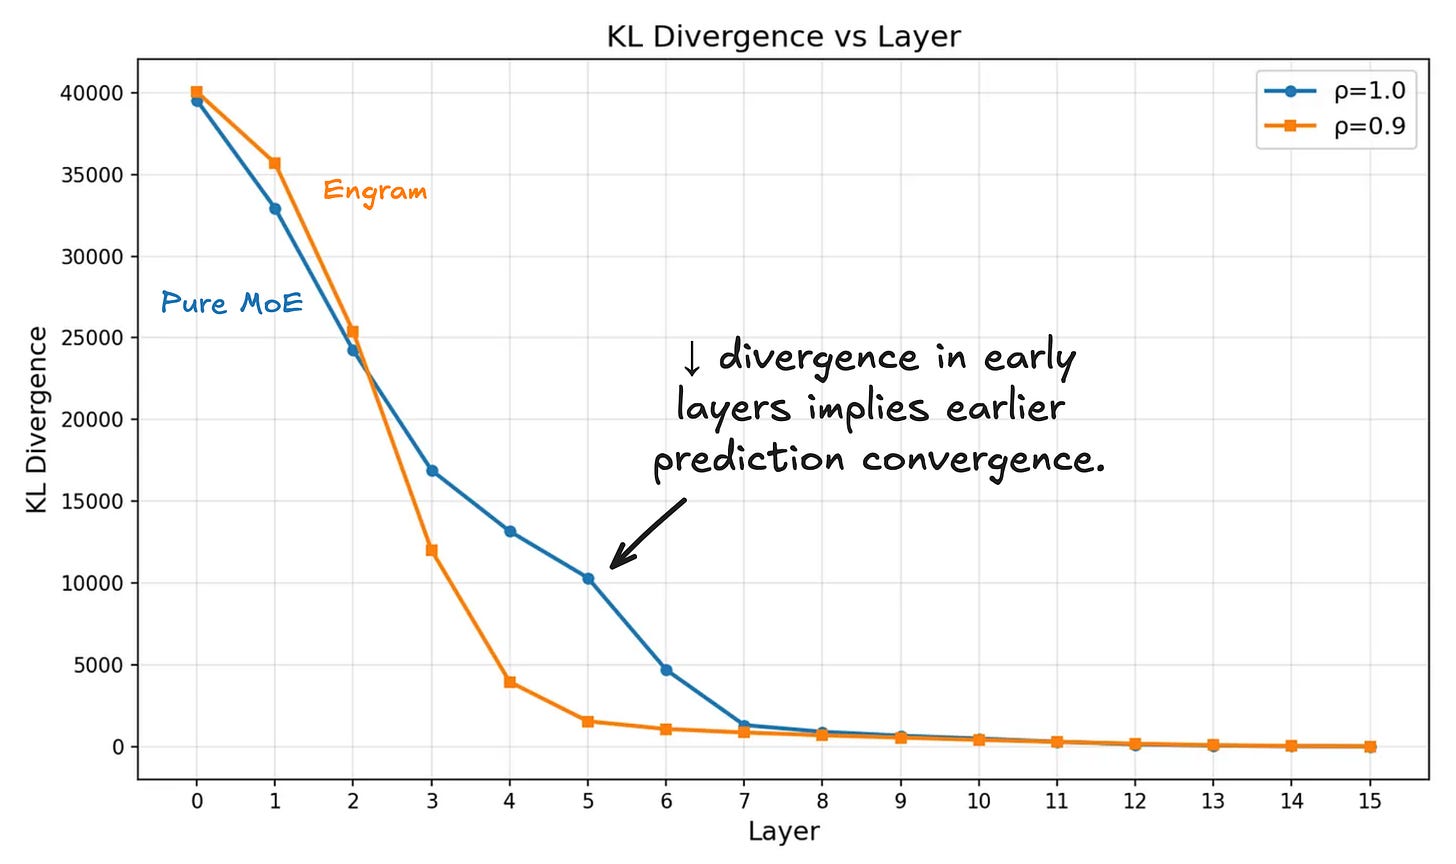
Engram通过引入学习型多token查找机制,对标准token嵌入进行了创新性扩展。这一技术能够直接检索重复出现的局部模式所对应的向量,显著降低了对通过注意力机制和前馈层重建向量的依赖,从而实现更高效的内存利用。
架构优化价值
Engram的模型架构优化带来了显著优势:在保持相同模型质量的前提下,大幅降低了对高带宽内存(HBM)容量的需求。这并不意味着HBM需求会减少,而是表明模型架构将持续围绕资源限制进行创新性设计,以实现更高效的资源利用。
内存分层管理
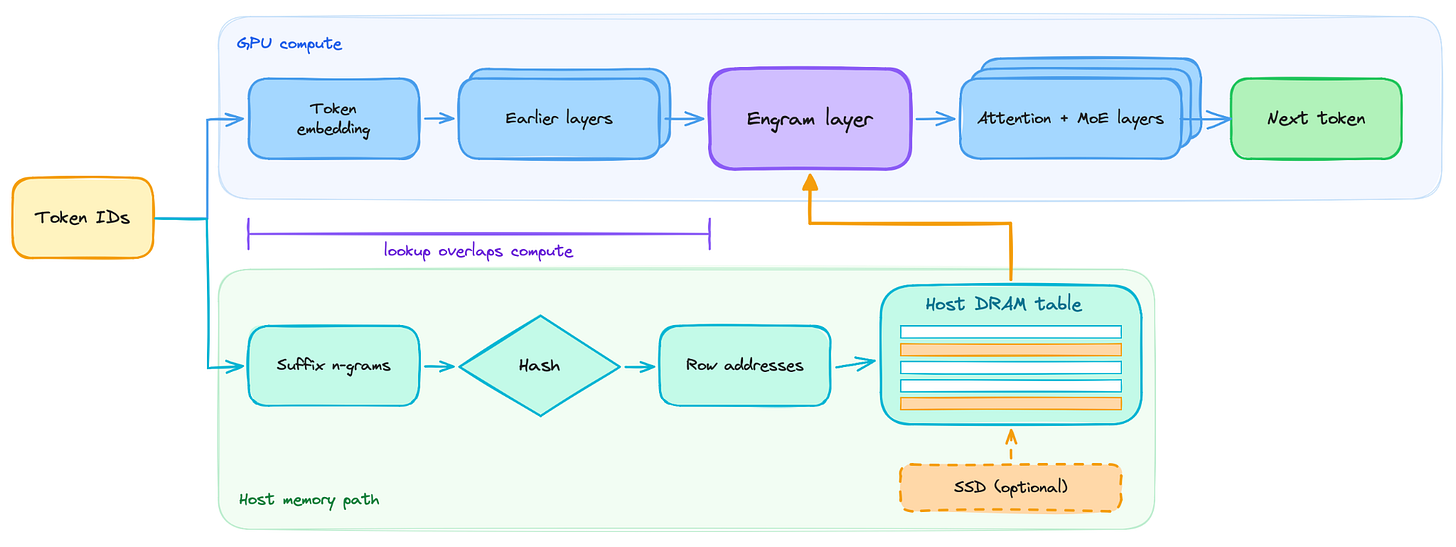
Engram的设计天然支持参数卸载机制。每个token仅需访问少数几行嵌入数据,而这些数据的地址仅依赖于token ID,而非隐藏状态。运行时可以在计算早期层的同时,从主机DRAM预取这些数据行,从而将表格保留在HBM外部,无需传输完整的权重矩阵。
- 释放HBM空间用于存储模型权重和KV缓存
- 支持更大批次处理或更多并发会话
- 当DRAM成为瓶颈时,NVMe可提供额外的存储层次
实际应用场景
推荐系统已经将频繁或最近访问的嵌入行缓存到更快的内存中,同时将较少访问的行存储在SSD中。这种分层存储策略在Engram框架下得到了进一步优化。例如,DeepSeek-V4.1-Flash配置使用了约189 GiB的Engram内存,通过内存映射(mmap)文件并卸载到SSD,实现了显著的性能提升。
实验结果与验证
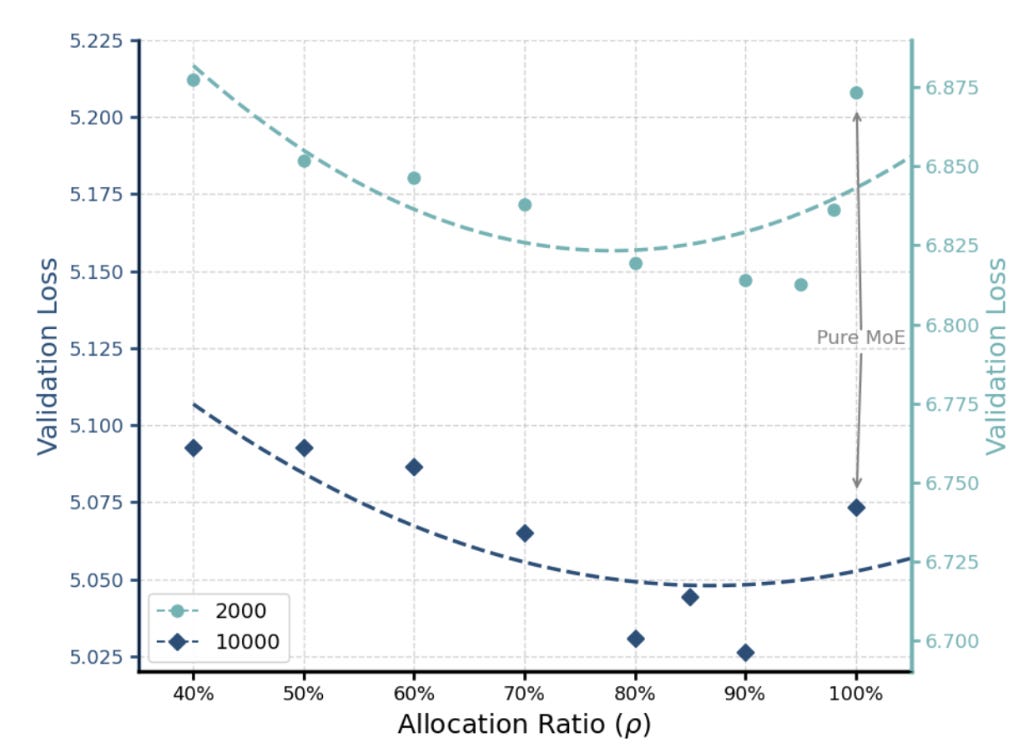
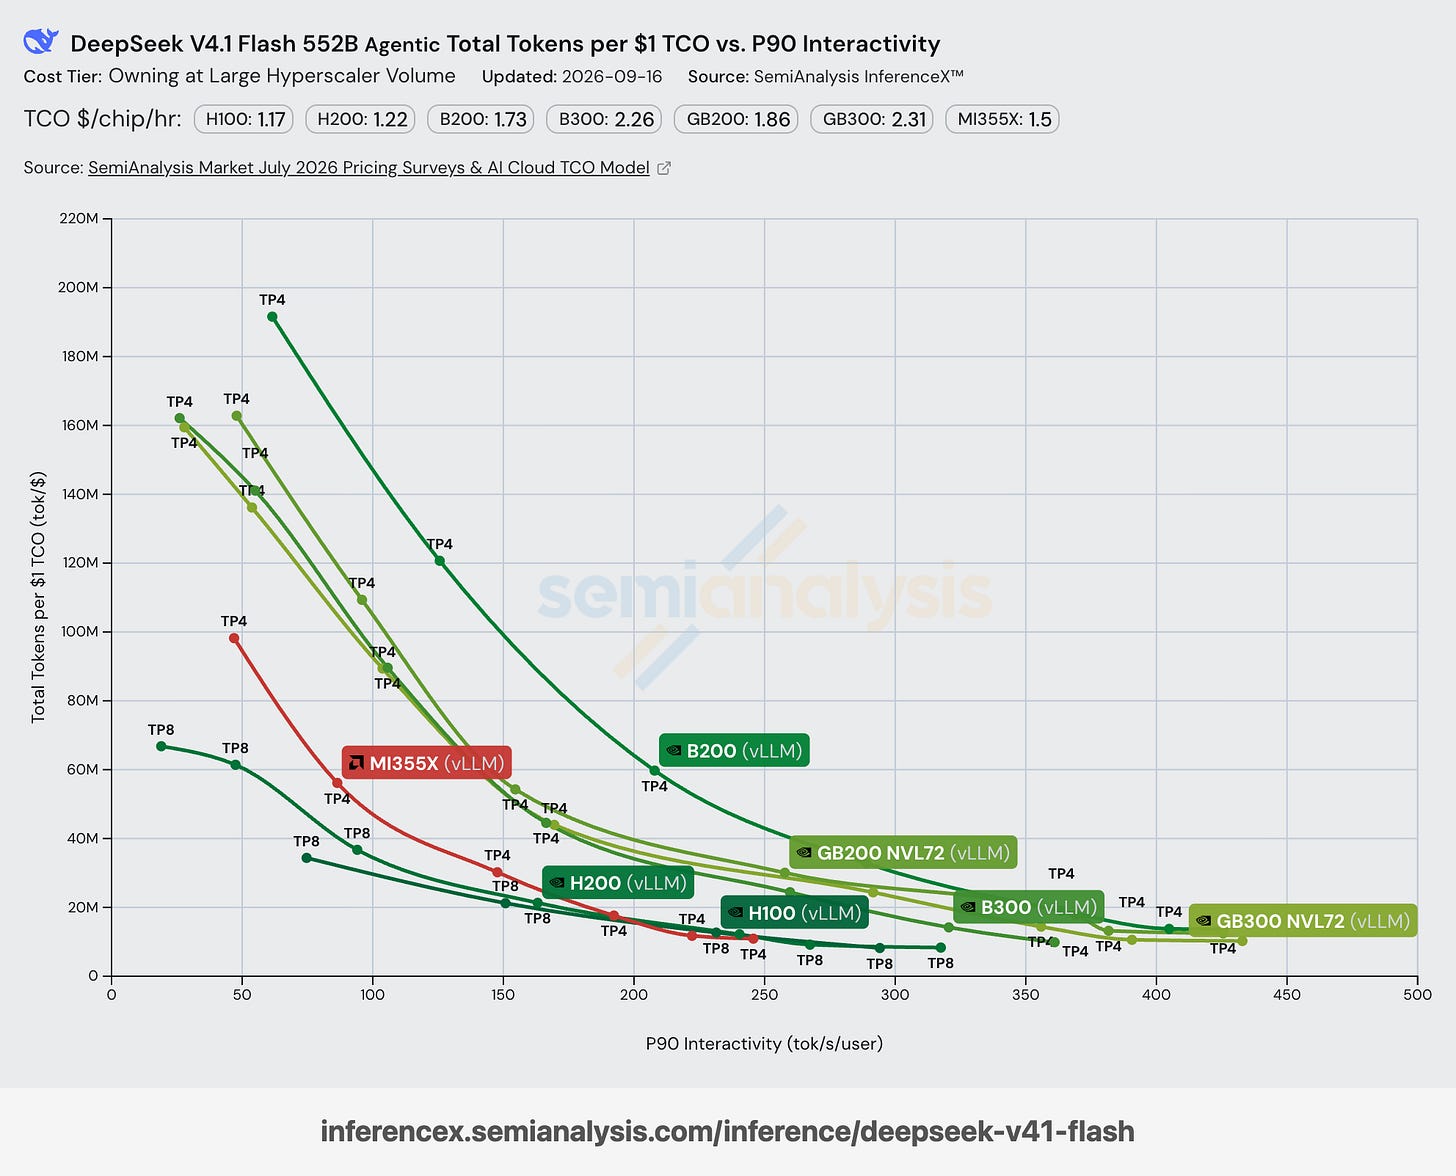
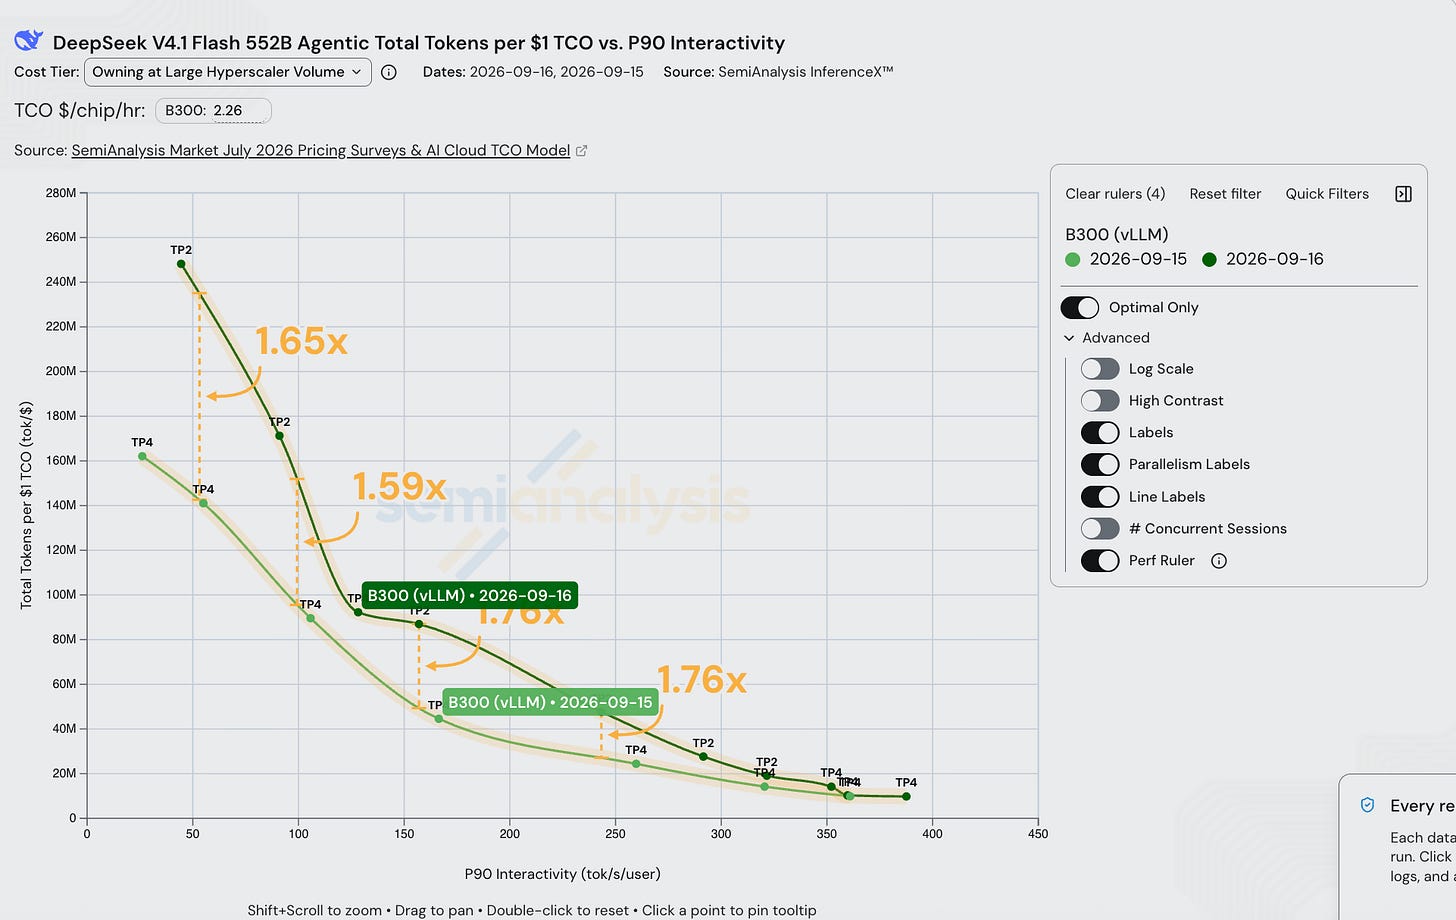
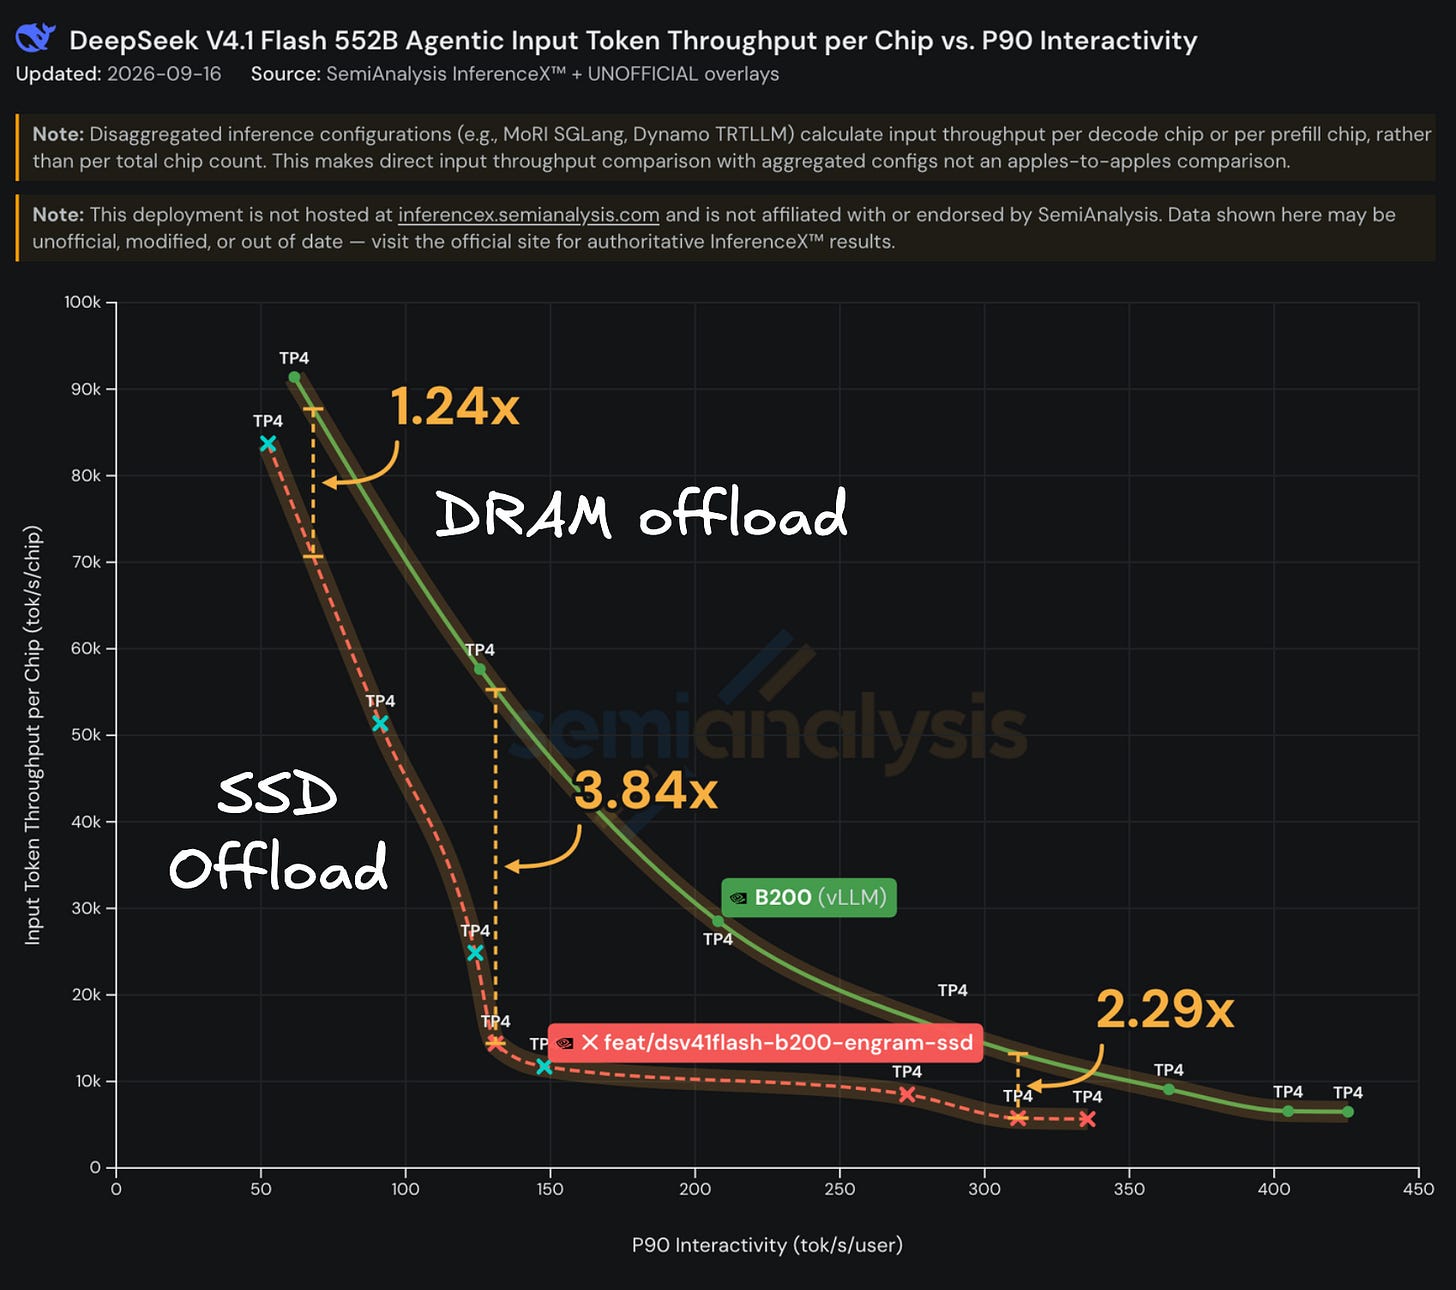
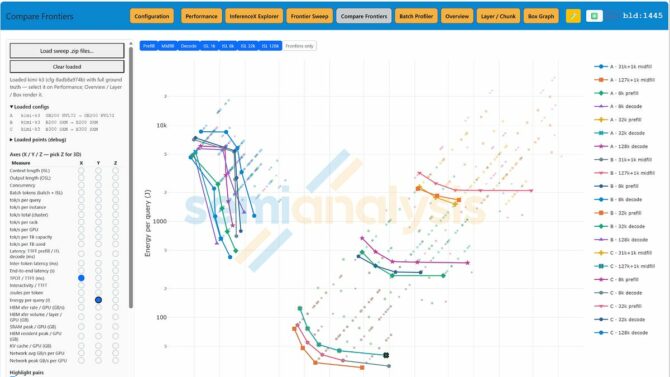
我们的实验展示了Engram卸载技术的卓越性能。即使在具有大容量HBM的SKU上,将Engram卸载到DRAM也能在大多数帕累托前沿实现比保留在HBM中更好的性能。这一发现对于资源受限环境下的AI部署具有重要指导意义。
广泛的行业支持
我们的基准测试得到了广泛认可和验证,几乎所有主要计算采购方都参与了验证,从Google Cloud到Microsoft Azure,再到Oracle和Meta等。此外,该技术还获得了机器学习社区的支持,包括vLLM、LMCache、SGLang、PyTorch、Huggingface等框架,以及OpenAI、MiniMax、ZAI、Qwen、Moonshot Kimi等主要实验室的支持。
InferenceX基准测试
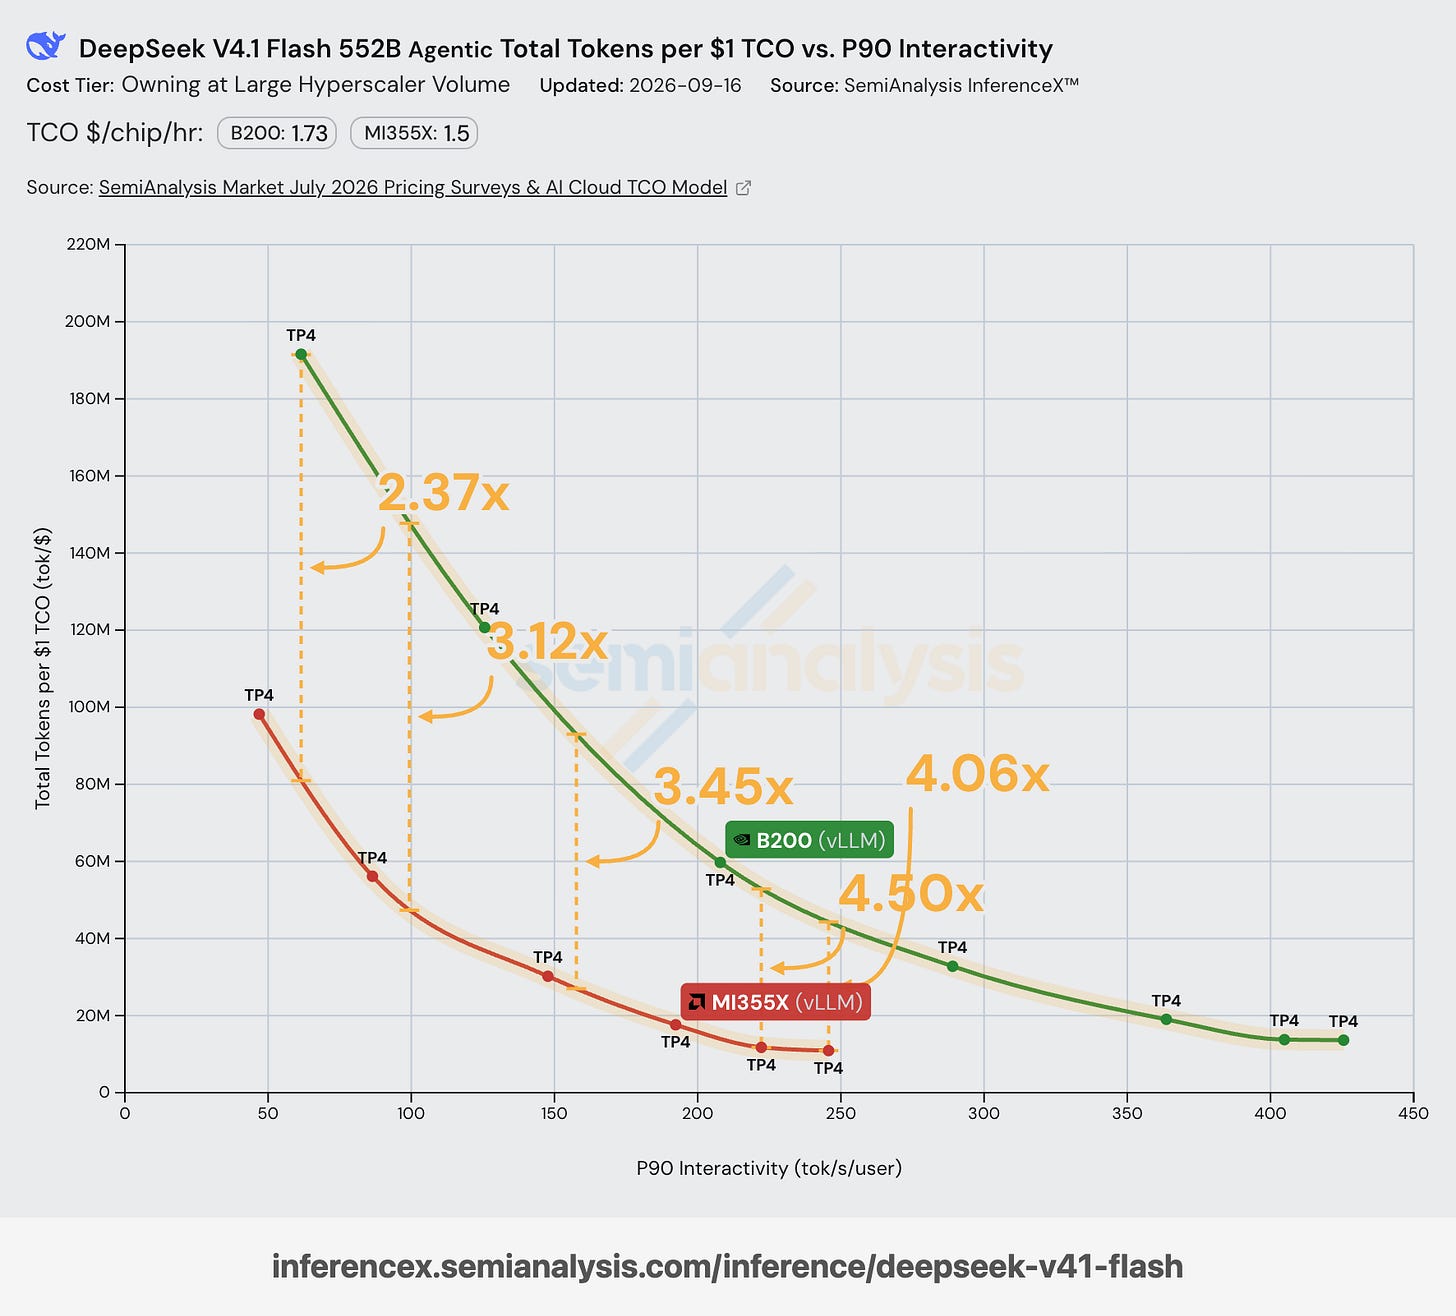
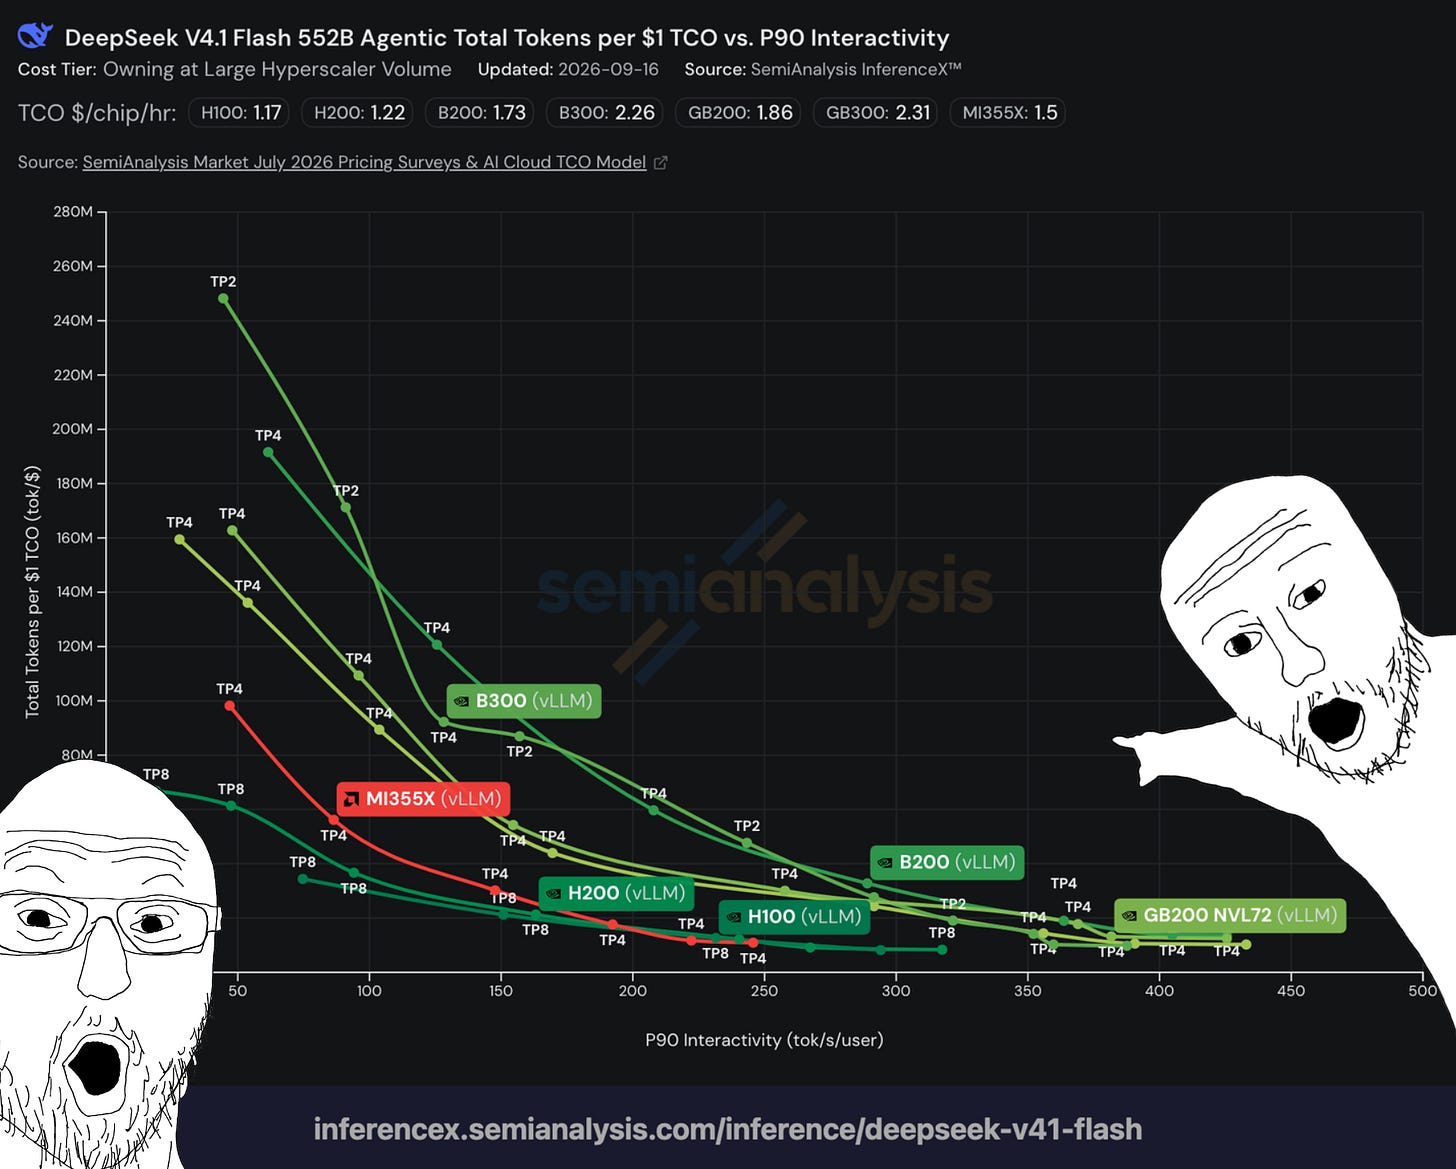
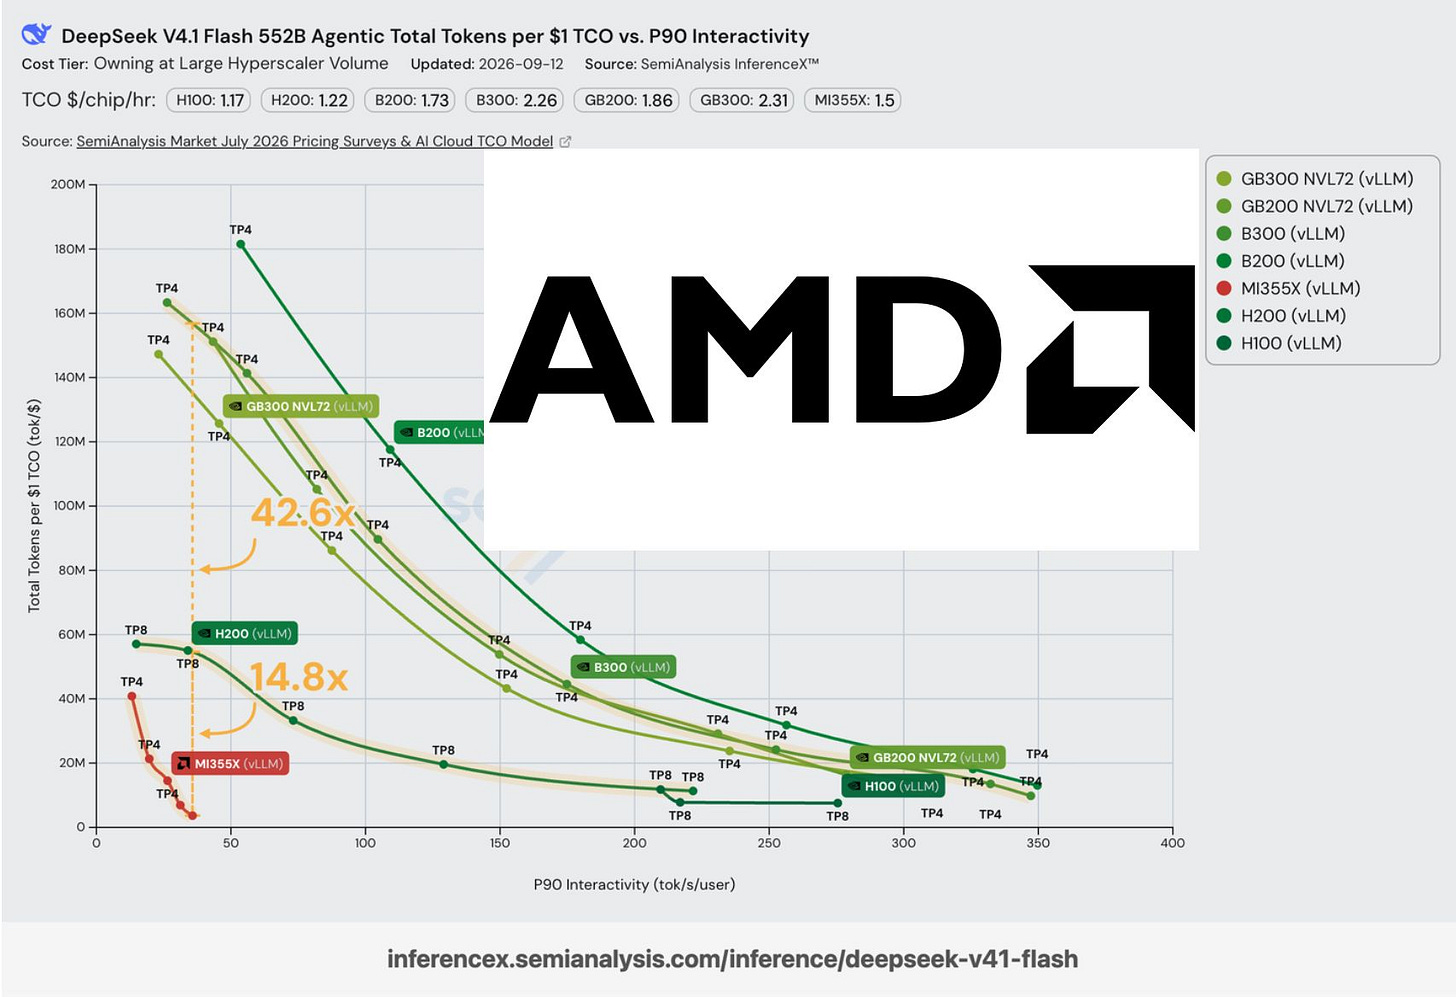
InferenceX是全球唯一包含TPUv7、Jalapeño、NVIDIA Rubin NVL72、AMD以及即将加入的SambaNova和Trainium芯片的推理基准测试。由于其AgentX场景与真实世界代理推理工作高度相似,AMD已承诺在MI455X UALoE72上进行合作。我们的基准测试还展示了在所有6款NVIDIA GPU SKU以及MI355X上运行DeepSeekV4.1 Flash等Engram模型的官方InferenceX代理推理服务结果。
关注微信号:智享开源 ,及时了解更新信息。

原文链接:https://newsletter.semianalysis.com/p/engrams-embedding-entendre-codesign
为你推荐

还没有任何评论,你来说两句吧!