高效推理:计算与数据流动解析

高效推理:计算与数据流动解析

专家混合模型带来的变革

如今广泛用于前沿模型的专家混合(Mixture of Experts)技术,彻底改变了服务架构和实用推理的经济性。这种创新不仅增加了参数数量,更重新定义了每个token的活跃张量分布,明确了哪些组件需要紧密相邻,哪些数据传输需要强大的本地带宽,哪些可以容忍较弱的网络连接,以及内存移动、存储和调度如何共同提升有效吞吐量。
集群中的推理服务架构

理解推理服务的最佳起点是将其视为一个整体。推理运行在由编排层协调的集群内,这些编排层包括NVIDIA Dynamo、Mooncake或自定义调度器等。这些系统与推理服务器如vLLM或SQlang紧密协作,而后者也具备自己的编排功能。本文将不深入探讨如何使用编排软件或如何选择特定工具,而是旨在概述各种功能背后的流程和原理。
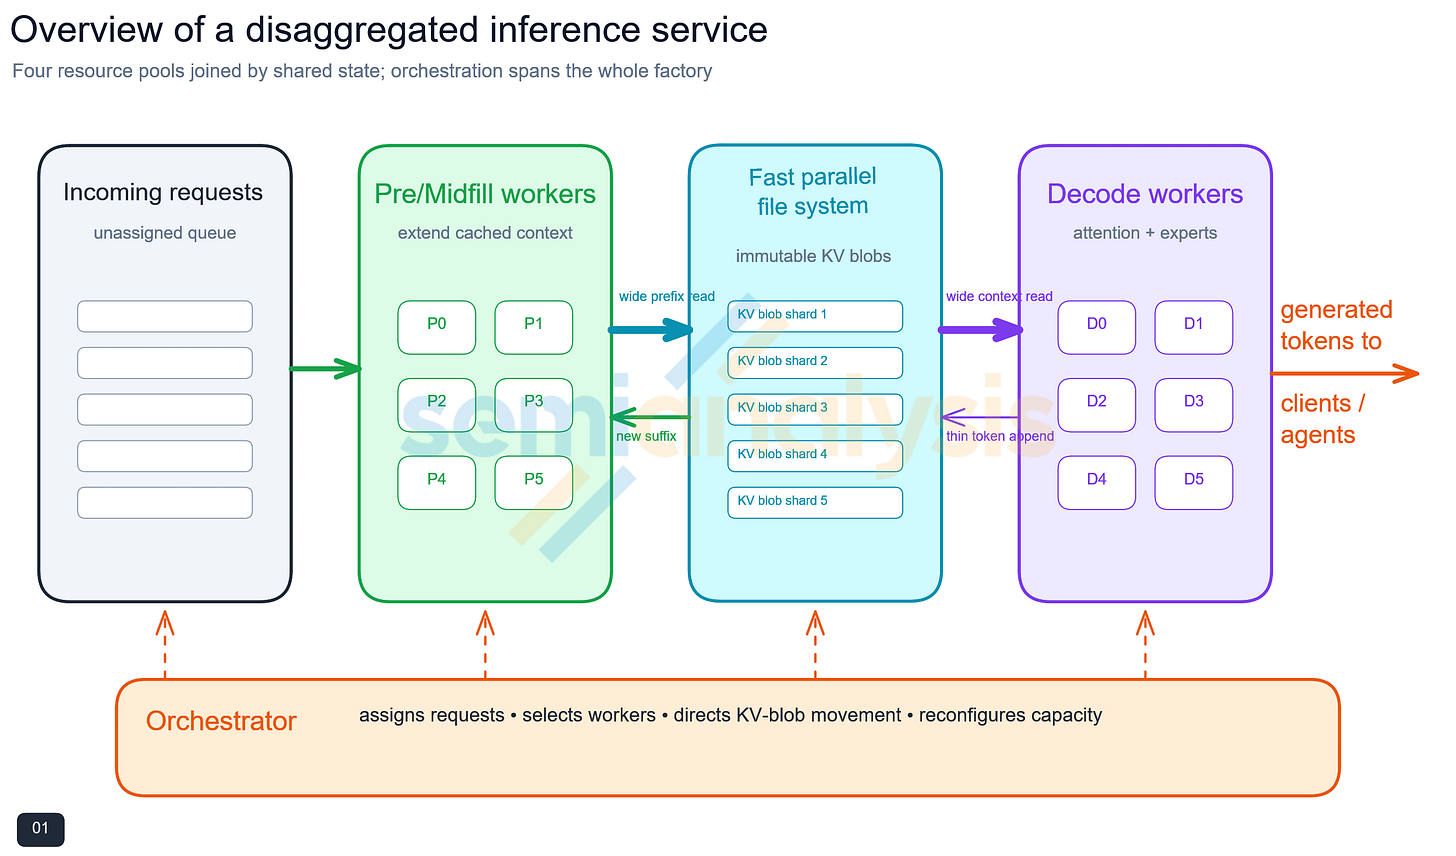
Figure 1. Overview of model stages in an inference service.

用户交互与对话流程

用户(或其代理)通过请求(query)开始对话,对话可能在收到答案后继续延伸。请求-回答构成一个”回合”(turn)。在现代AI系统中,用户通常在客户端应用程序中运行(无论是GUI还是命令行界面),部分AI返回的答案会被该应用程序拦截作为执行指令,例如编辑代码或根据HR问题搜索公司指南。
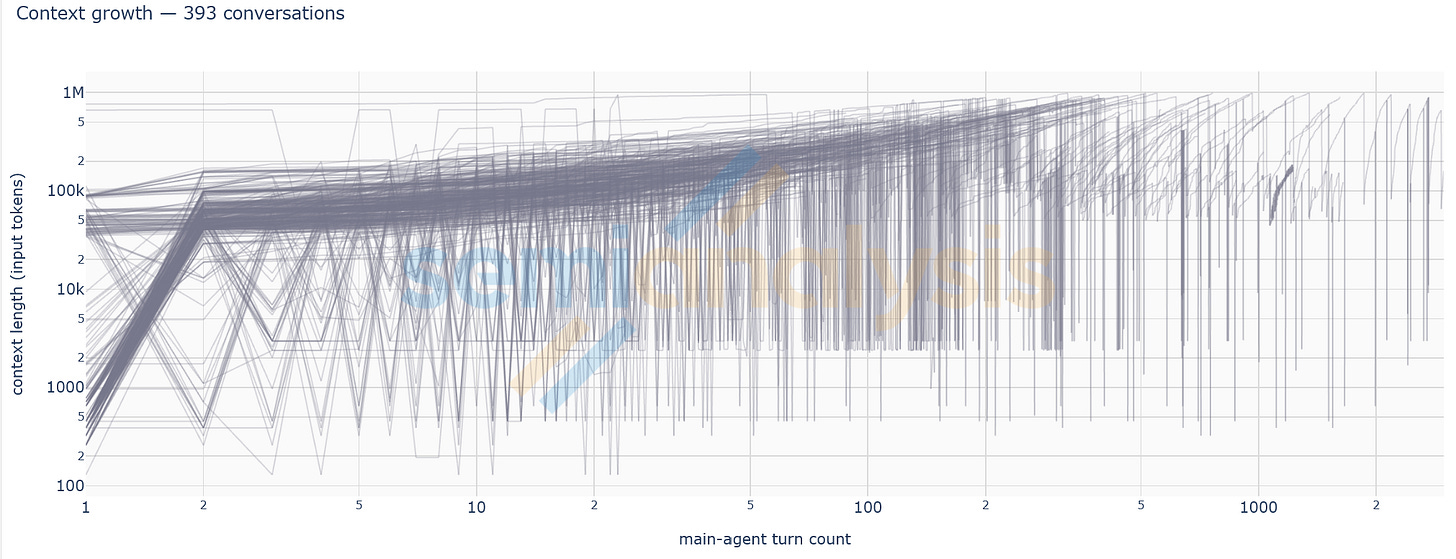
Figure 2. "CC Traces Weka" dataset contributed to AgentX, release 34. Source: SemiAnalysis AgentX.

AI系统也可以从其数据中心执行部分操作,例如搜索网络。这些拦截工具操作的结果同样作为请求返回给AI,形成更多回合。服务器会维护一个上下文(通常称为KV缓存或简称为缓存),它是会话的精华,允许每个新请求(来自用户或工具)被正确解释以实现整体前进。当用户启动代理处理长期任务时,每小时可能产生数千个回合。对话也可能暂停并在数小时甚至数天后恢复。

请求处理流程
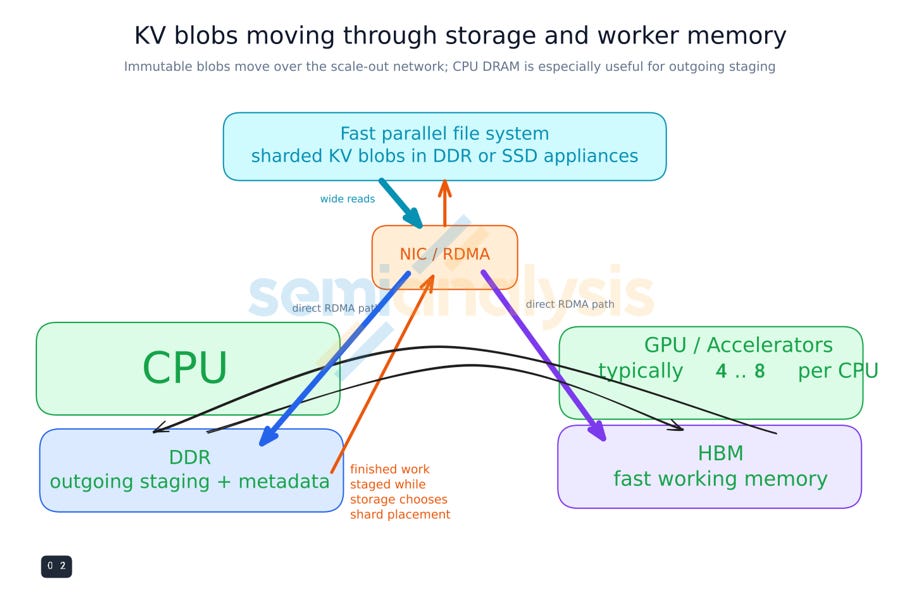
Figure 5. KV blobs moving through storage and worker memory.

当请求到达推理服务器时,编排层将其放入队列,同时输入填充(input-fill)工作程序会处理系统提示和先前对话中的上下文。随后查询被转换为追加到对话中的新上下文。这个新的上下文状态会被移动到解码工作程序。解码过程会重复读取累积的状态,生成答案token,这些答案token也会被追加到对话状态。这一过程可能涉及工具、代理、用户输入填充等多个环节。在GPU上运行的模型工作程序只是这个token工厂的一部分;存储、网络和编排连接了各个阶段。

四种操作模式
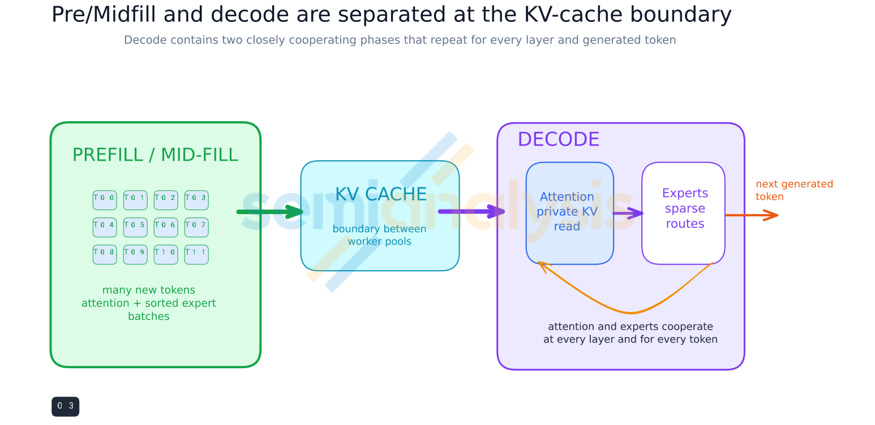
Figure 6. Prefill and midfill are separated from the closely coupled decode loop at the KV-cache boundary.

在工作程序内部,值得从开始就区分四种操作模式:

  • 预填充(Prefill):初始的新token块被一起处理。
  • 中填充(Midfill):将延续请求追加到现有缓存上下文中。
  • 解码注意力(Decode attention):使用上下文生成新token的基础。
  • 解码专家(Decode experts):从大量可能的专家中选择部分来完善每个基础新token。
这些模式对计算、内存和网络有不同需求。预填充和中填充密切相关,预填充可视为零先前上下文的中填充。然而,预填充是一种常见特例,对应于经典的”聊天机器人”一次性查询,可以比中填充进行不同的优化。预填充达到高算术强度(计算与数据移动的比率),且无需等待上下文被定位和读取。中填充从现有的KV缓存开始,追加新的请求输入序列。通常具有比预填充更适中的算术强度,因为每个token的新token较少,而需移动的现有数据更多。

解码注意力和解码专家工作通常算术强度较低,因为与先前上下文或专家权重相比,新token很少。同时,在所有这些模式中,注意力和专家的张量与token值无关,因此可以共享单次张量读取,尽可能多地供排队使用的token共享,即使是来自其他用户且在网络足够紧密以共享的不相关请求的token。将所有四种模式视为相同的工作负载会放弃MoE模型在强度和不同共享模式方面的结构优势。
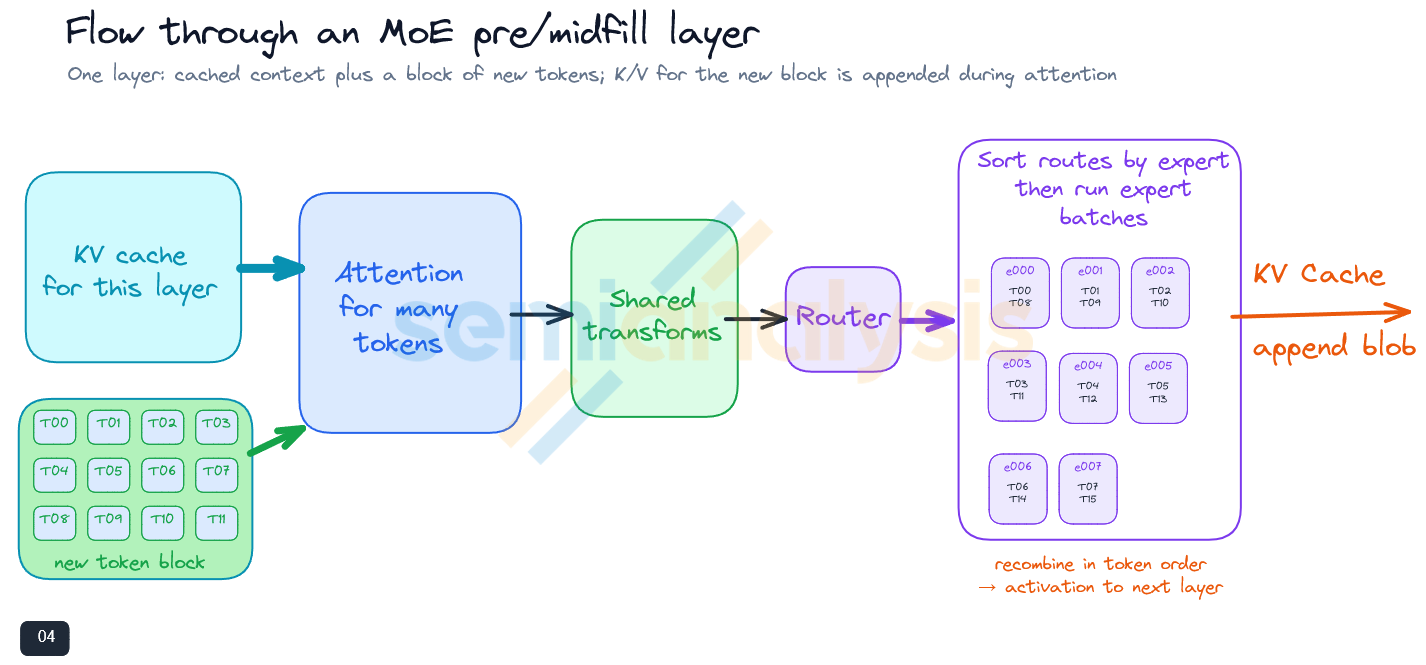
Figure 7. Flow through an MoE prefill layer.

模型与硬件架构

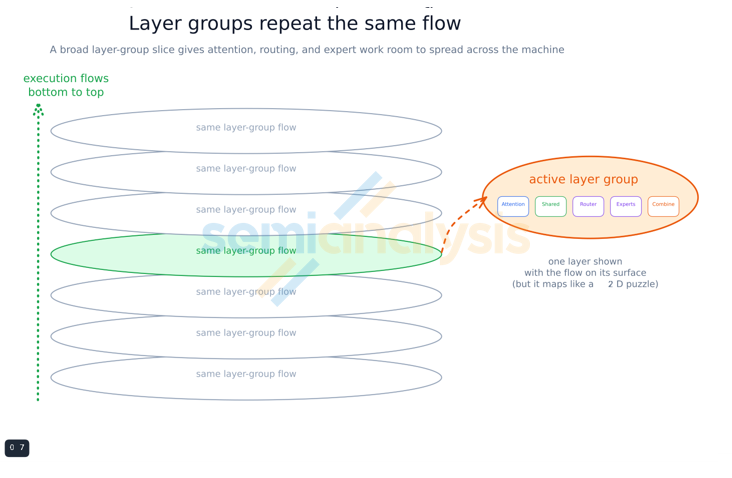
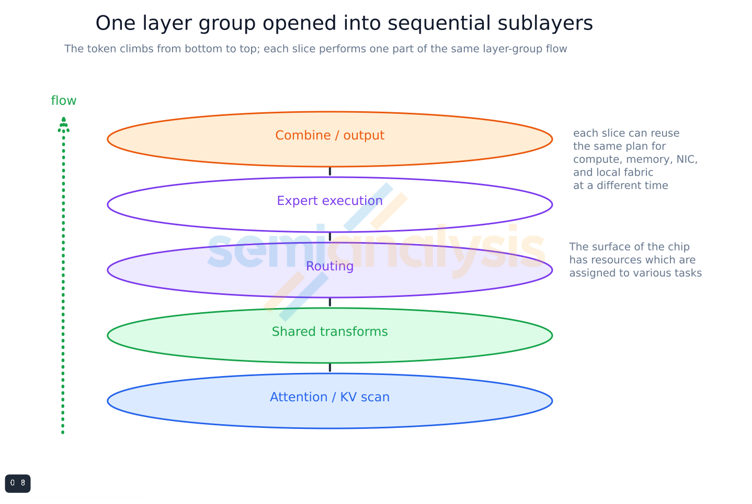
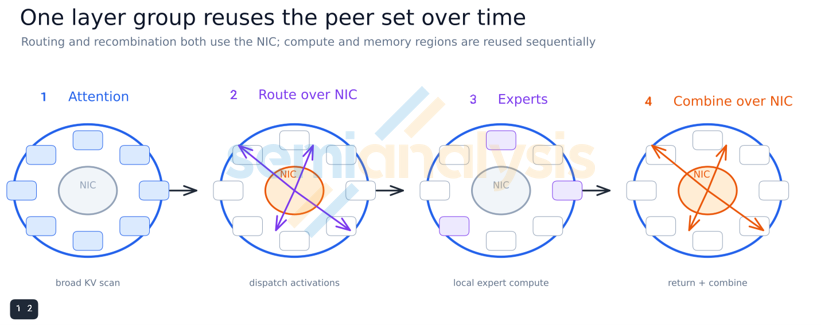
transformer模型是重复层组的深度堆栈。一个组可能包含一种类型的层,或者包含一个全注意力层与几个线性、局部、选择性或其他优化注意力层(这是一个混合层组)。在每个层内,注意力、共享变换、路由、选定专家和重组按顺序发生。这些步骤是预先知道的并持续重复,允许相同的硬件资源在不同时刻处理流程的不同部分。
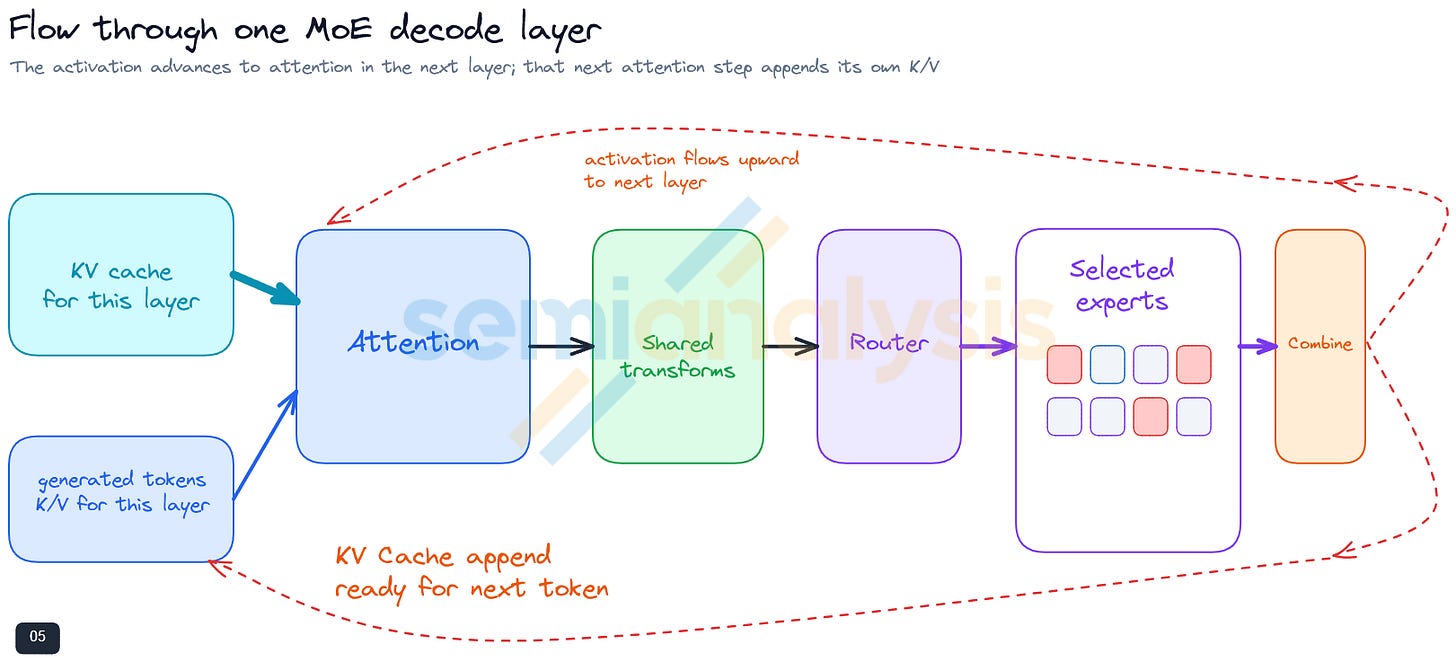
Figure 8. Flow through one MoE decode layer.

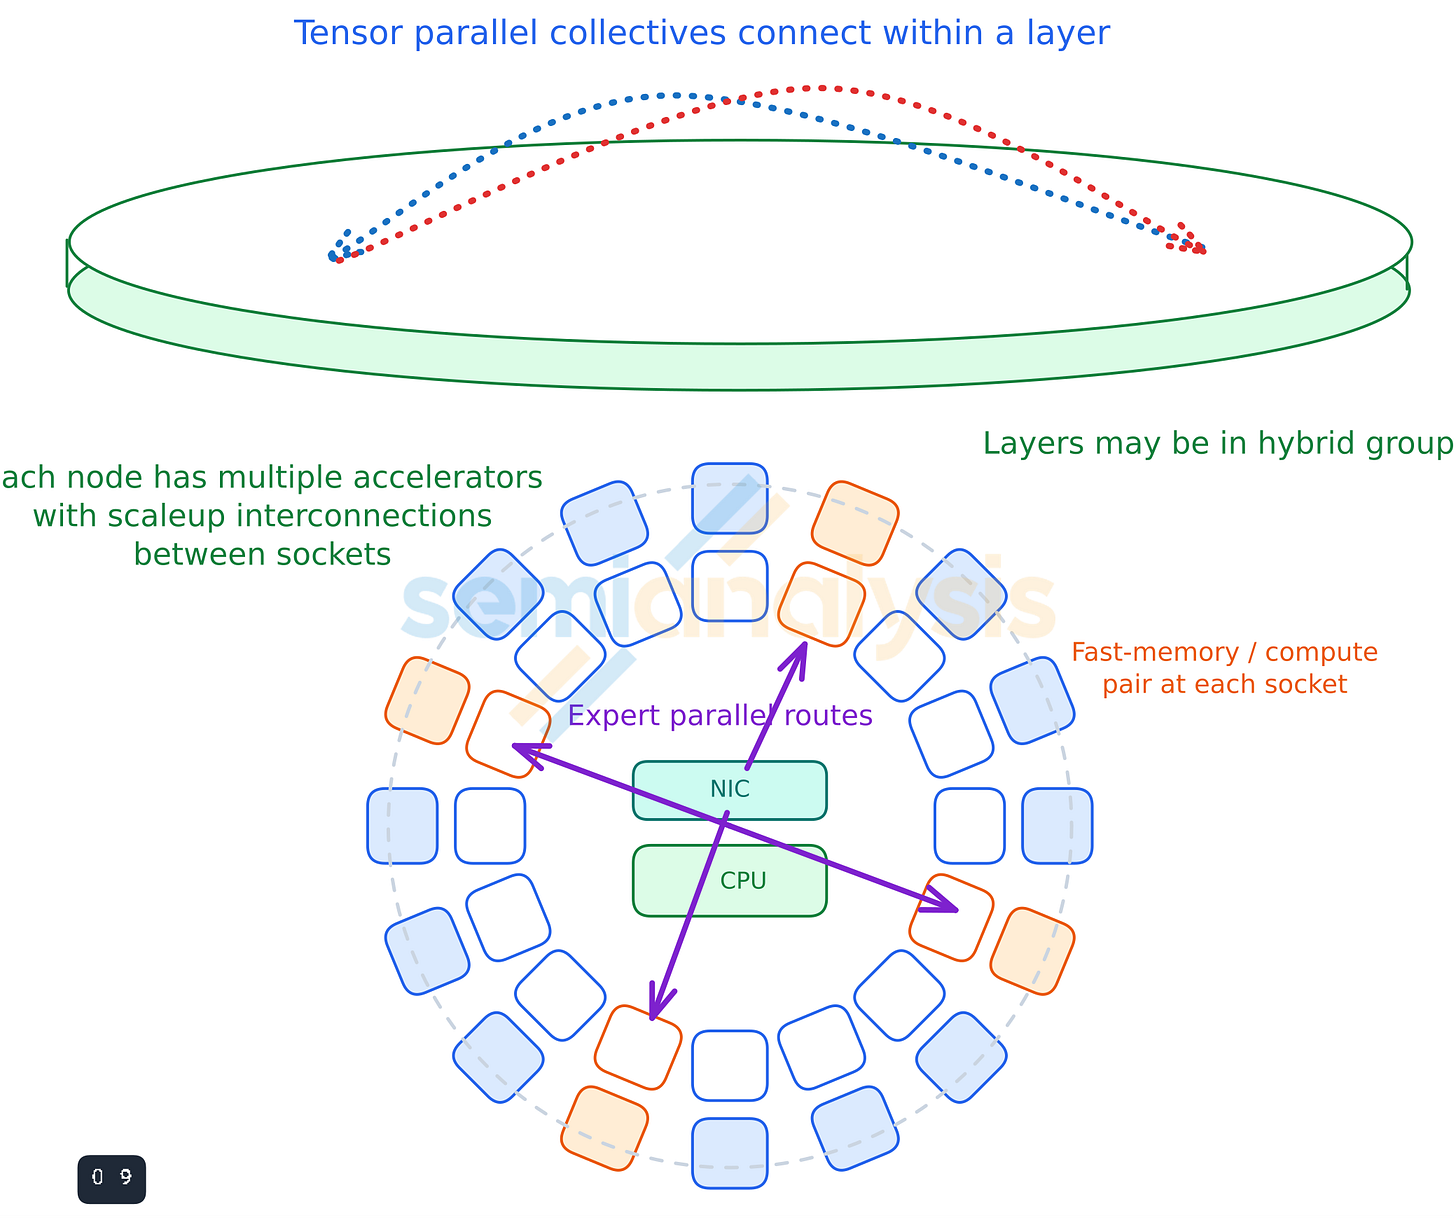
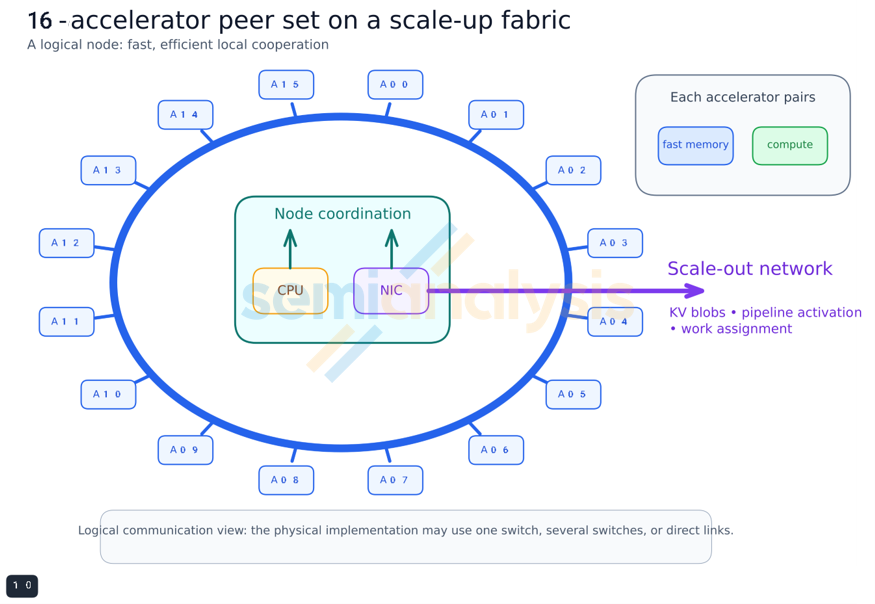
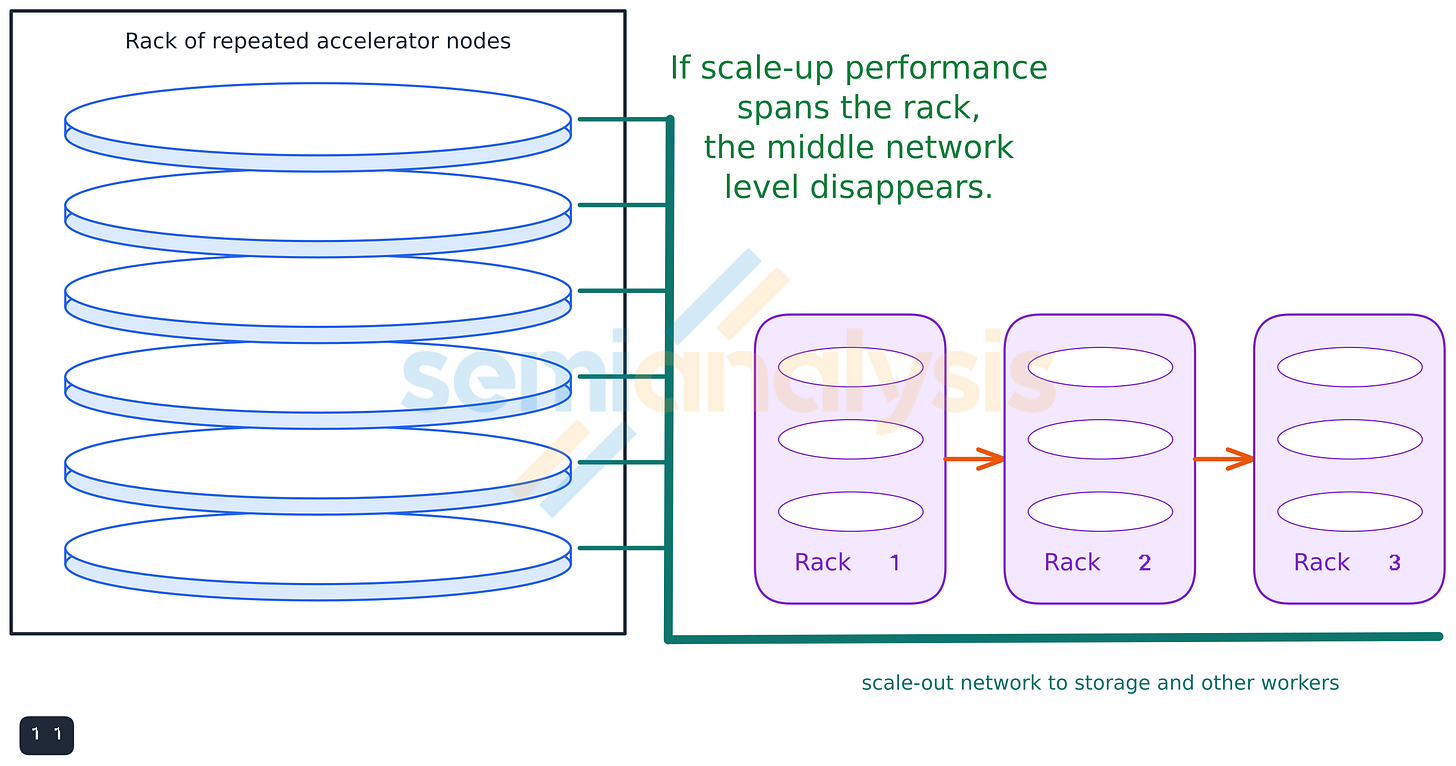
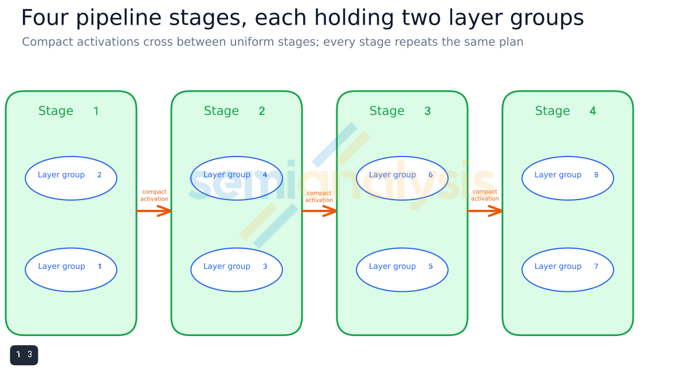
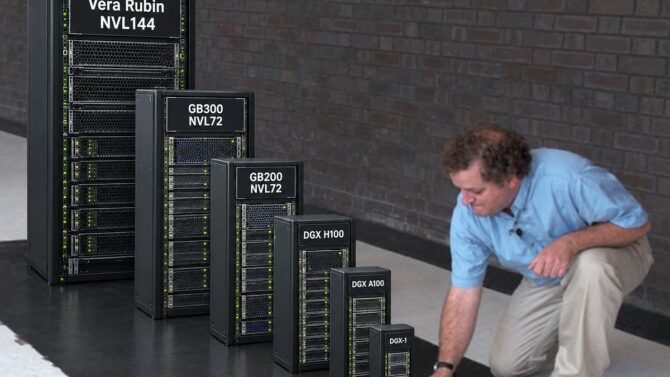
机器也可以被描述为同样简单的重复单元。节点是一组加速器,通常是机架中的一个托盘,每个加速器将计算与本地快速内存配对。节点由CPU协调,通过网络接口控制器(NIC)连接到其他节点。节点堆叠成机架。机架在处理非常大张量时可以作为一个扩展域,几个较小的扩展岛,或一组流水线阶段。数据中心网络将有限的工作程序连接到存储和编排,而不参与每个内部张量操作。

本文将遵循这一进展。从全局服务和操作模式开始,然后深入到模型的宽层组切片,将其映射到加速器节点和机架上。接着探讨流水线、张量和专家并行性;KV缓存内存的限制;预填充、中填充和解码中批处理的不同价值;以及在多机架token工厂中调度的作用。
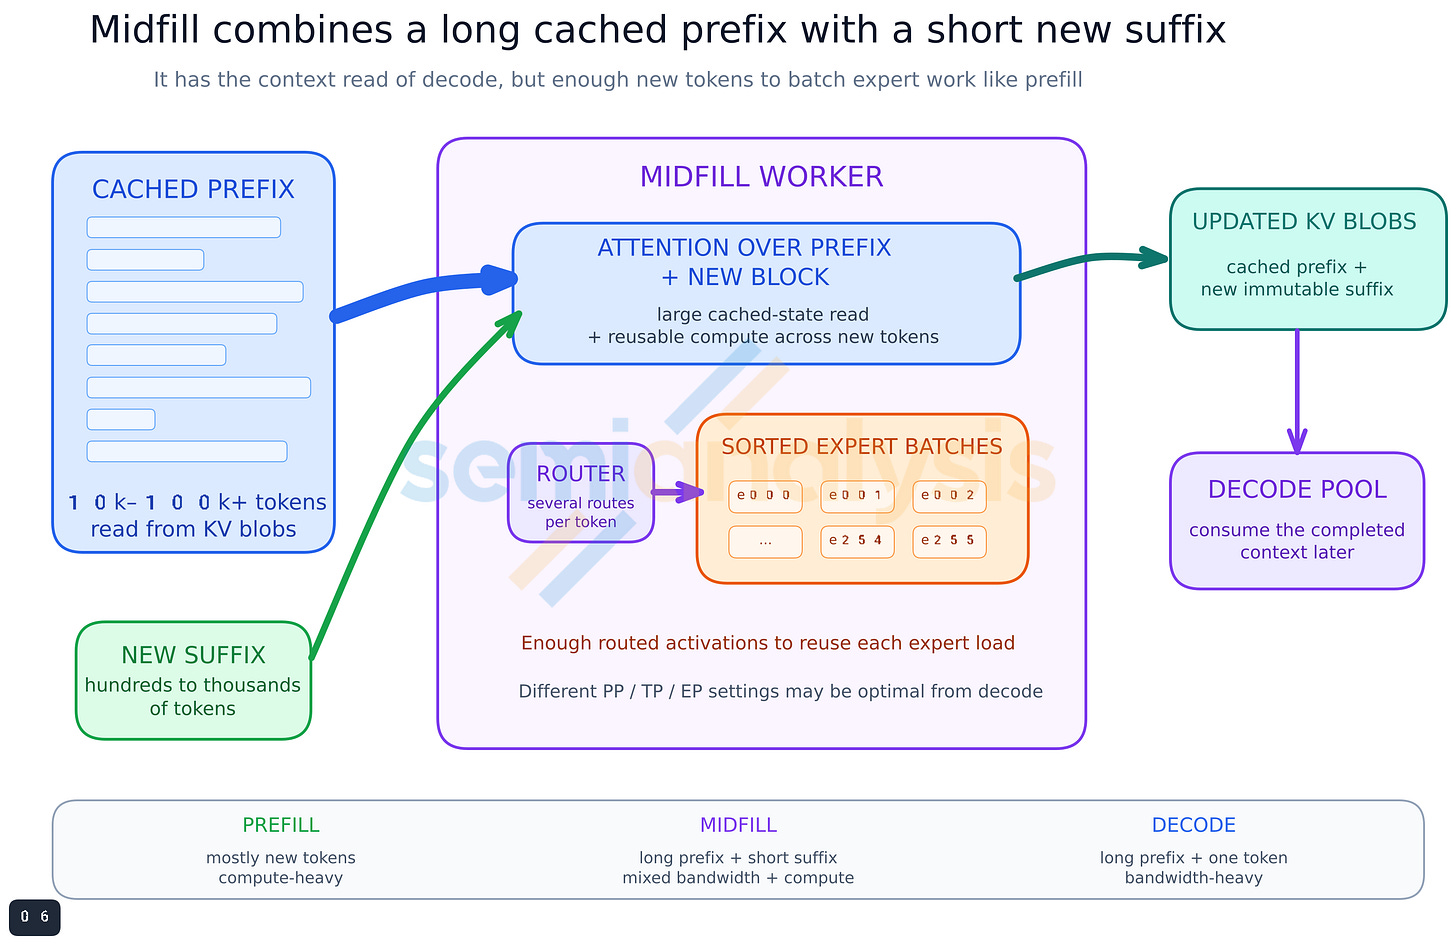
Figure 9. Midfill combines the cached-state read of decode with enough new tokens to batch model and expert work.


关注微信号:智享开源 ,及时了解更新信息。
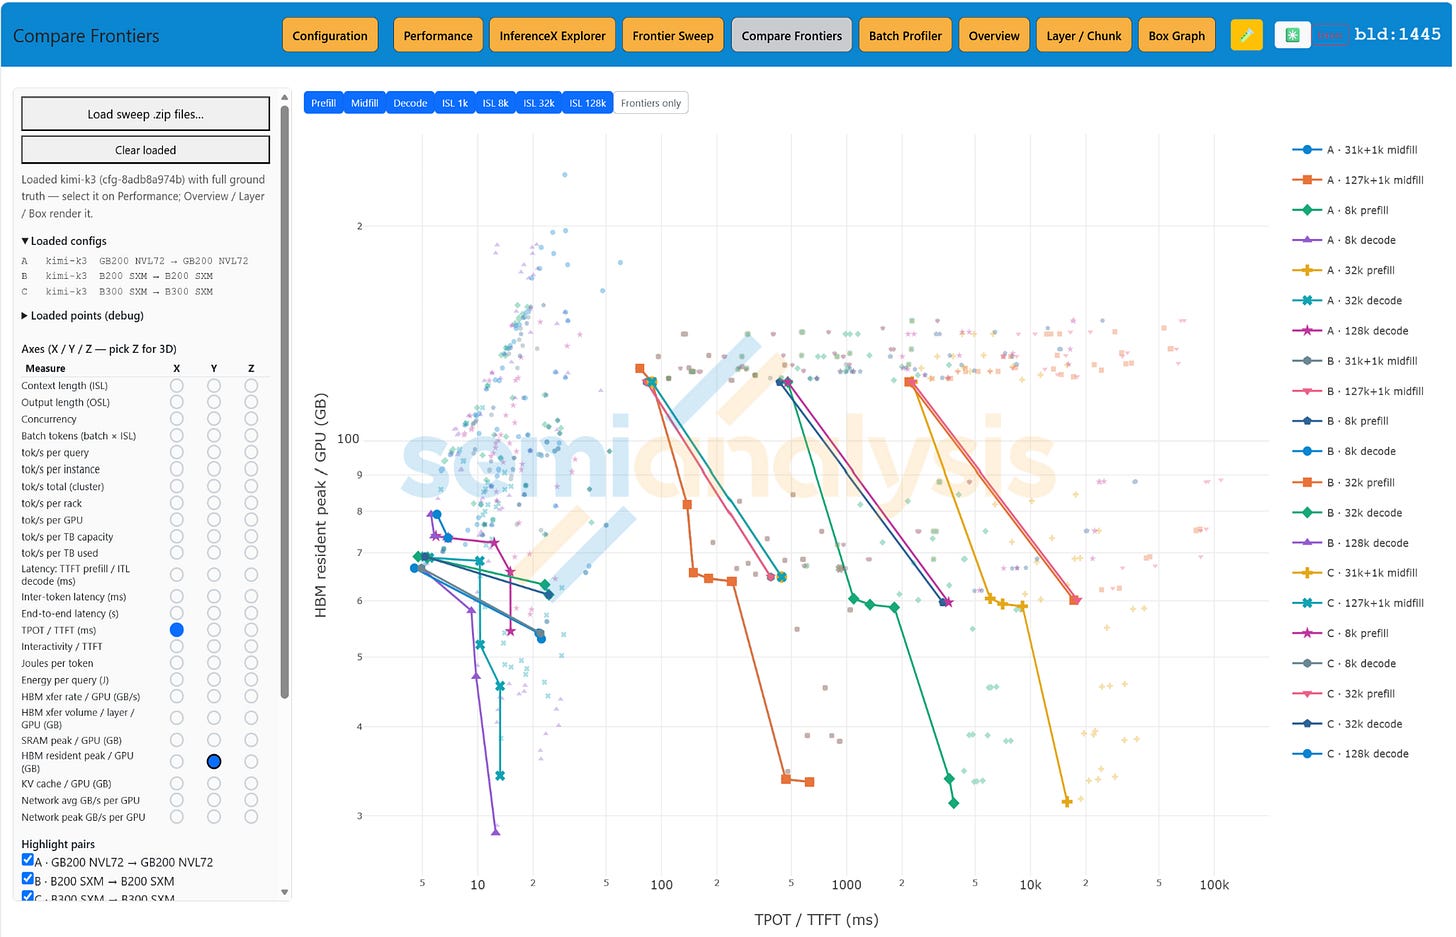
Figure 10. Layer groups repeat the same flow.

Figure 11. One layer group opened into sequential sublayers.

Figure 12. Pipeline, tensor, and expert parallelism follow different dimensions of a layer group.

Figure 13. A 16-accelerator peer set on a scale-up fabric.

Figure 14. Accelerator nodes stacked into a rack.

Figure 15. One layer group reuses the peer set over time.

Figure 17. Four uniform pipeline stages.

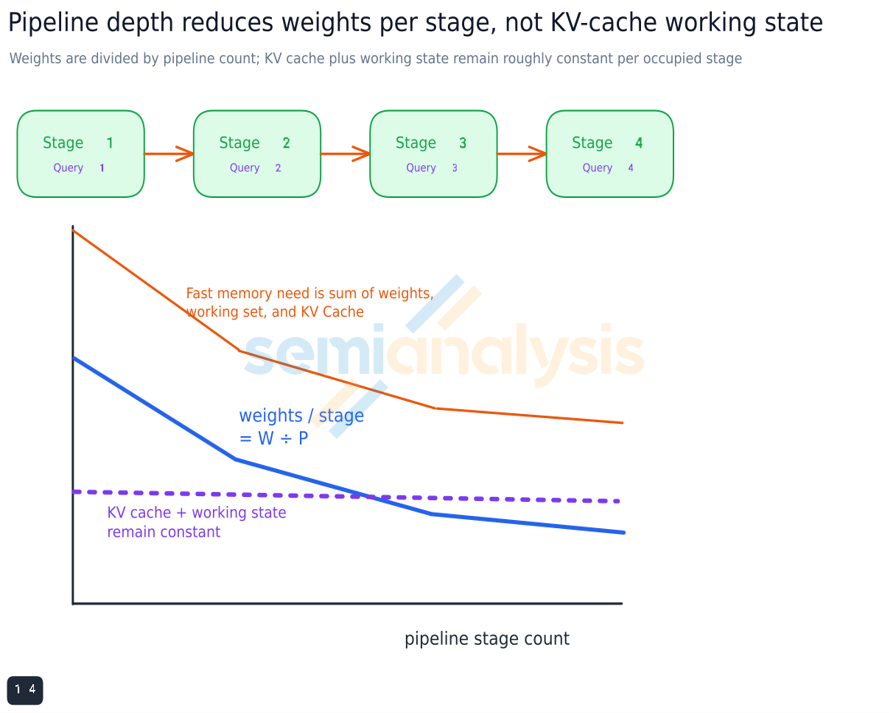
Figure 18. Fast-memory demand is stage weights, live KV state, working buffers, and margin.

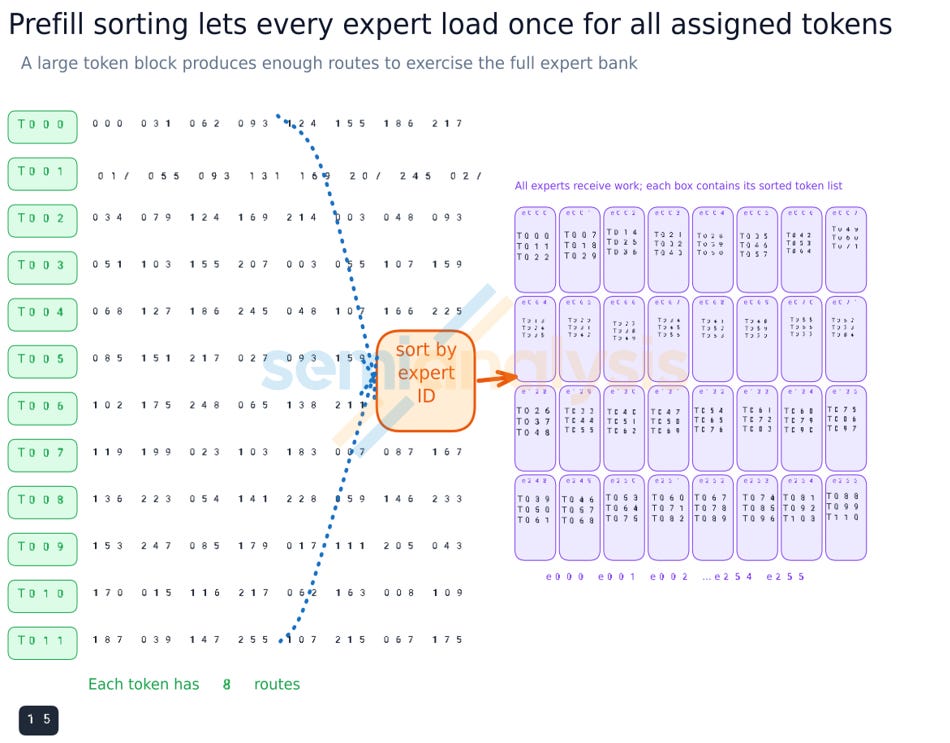
Figure 19. Sorting lets each expert load once and process every token assigned to it.

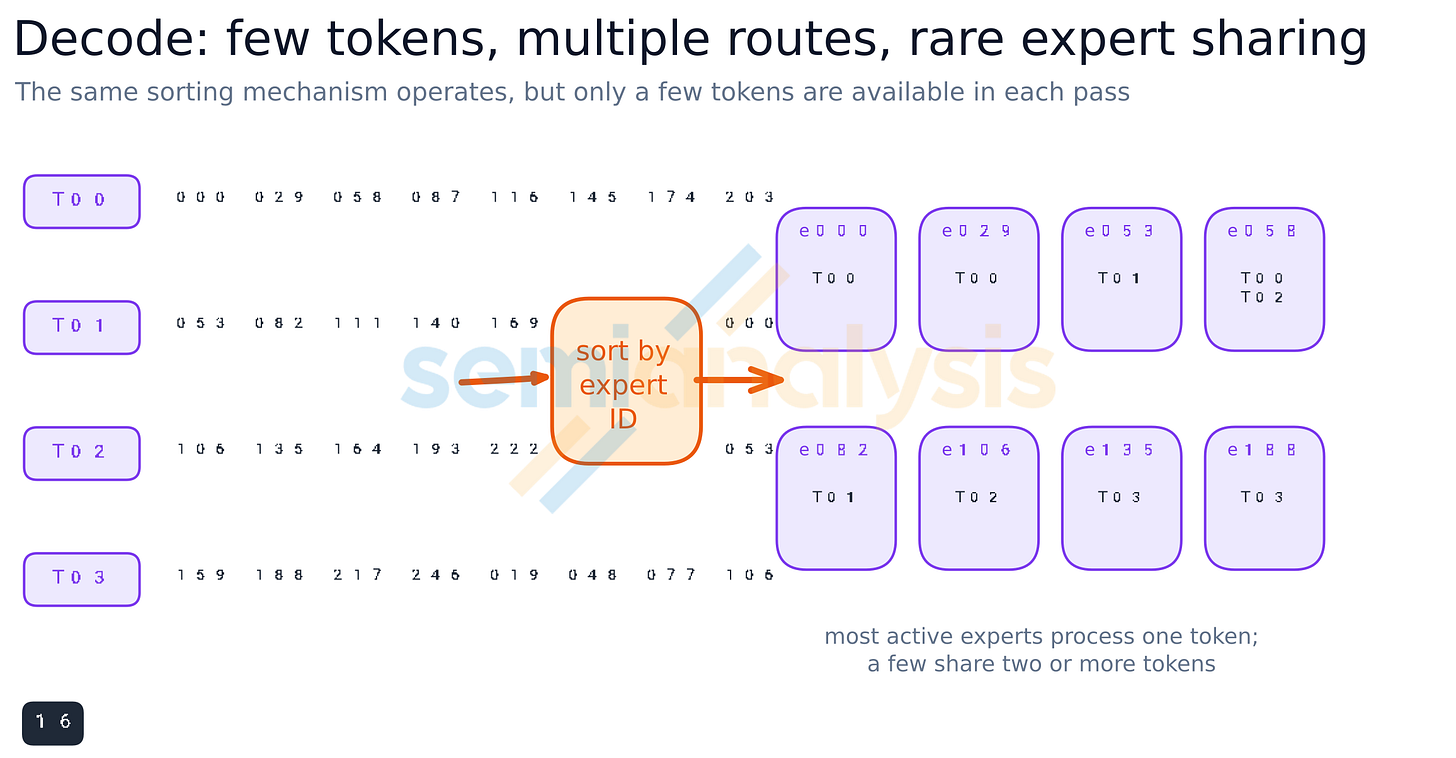
Figure 20. Decode uses multiple routes but rarely shares experts at small batch sizes.

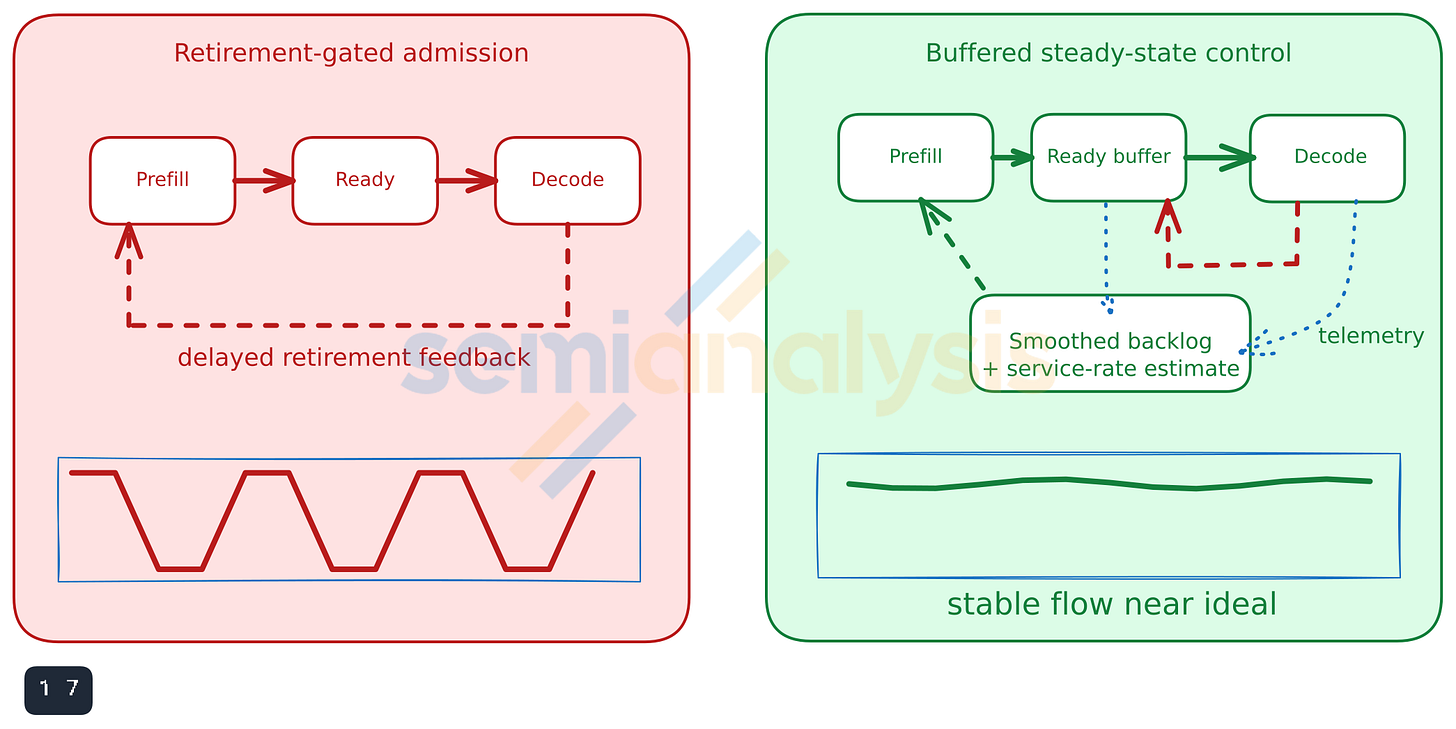
Figure 21. From retirement-gated oscillation to steady flow.

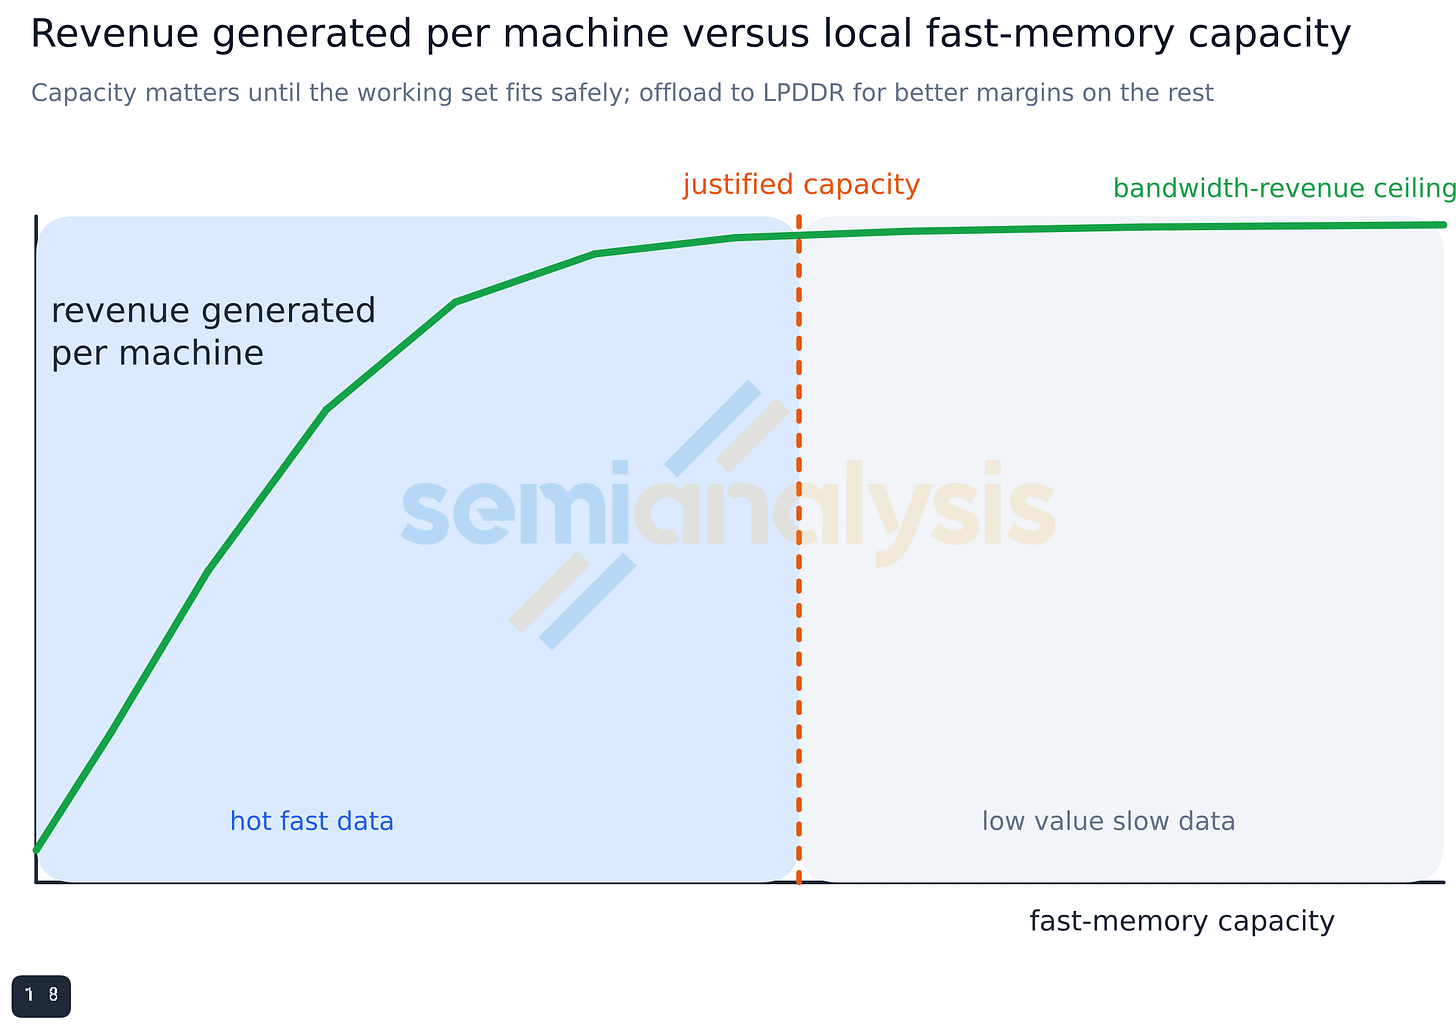
Figure 22. Revenue per machine versus local fast-memory capacity.

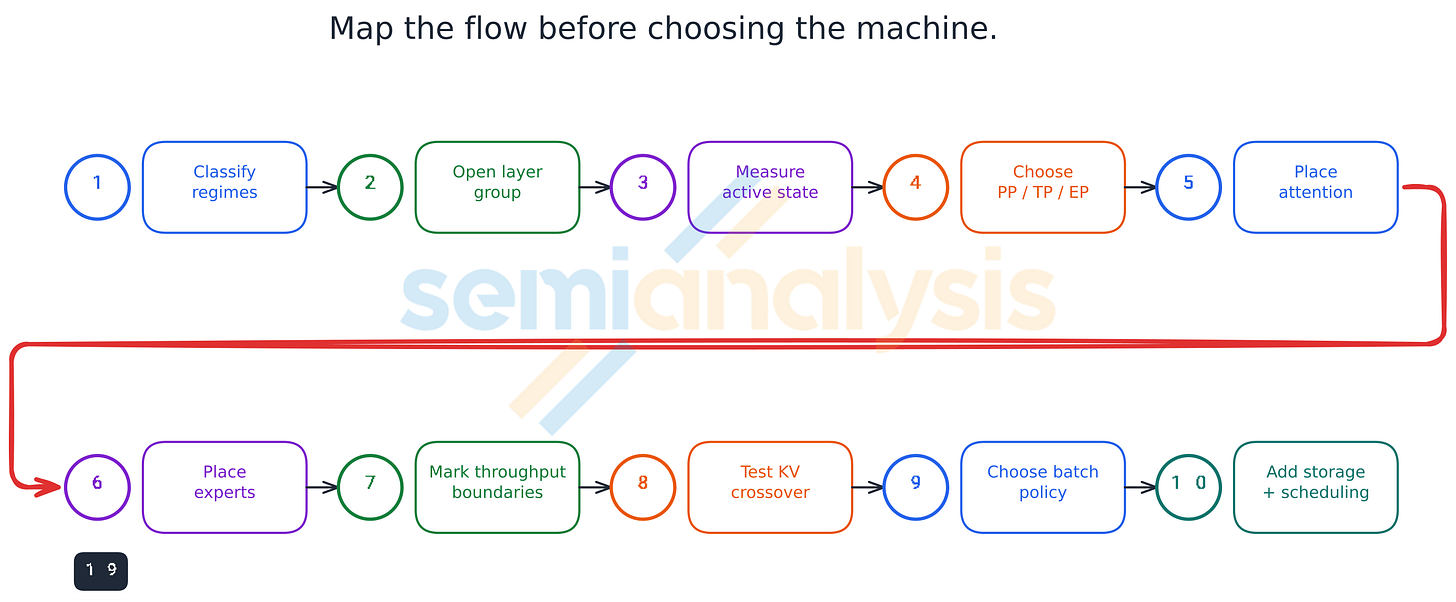
Figure 23. A practical sequence for mapping the model onto a worker and then into a token factory.

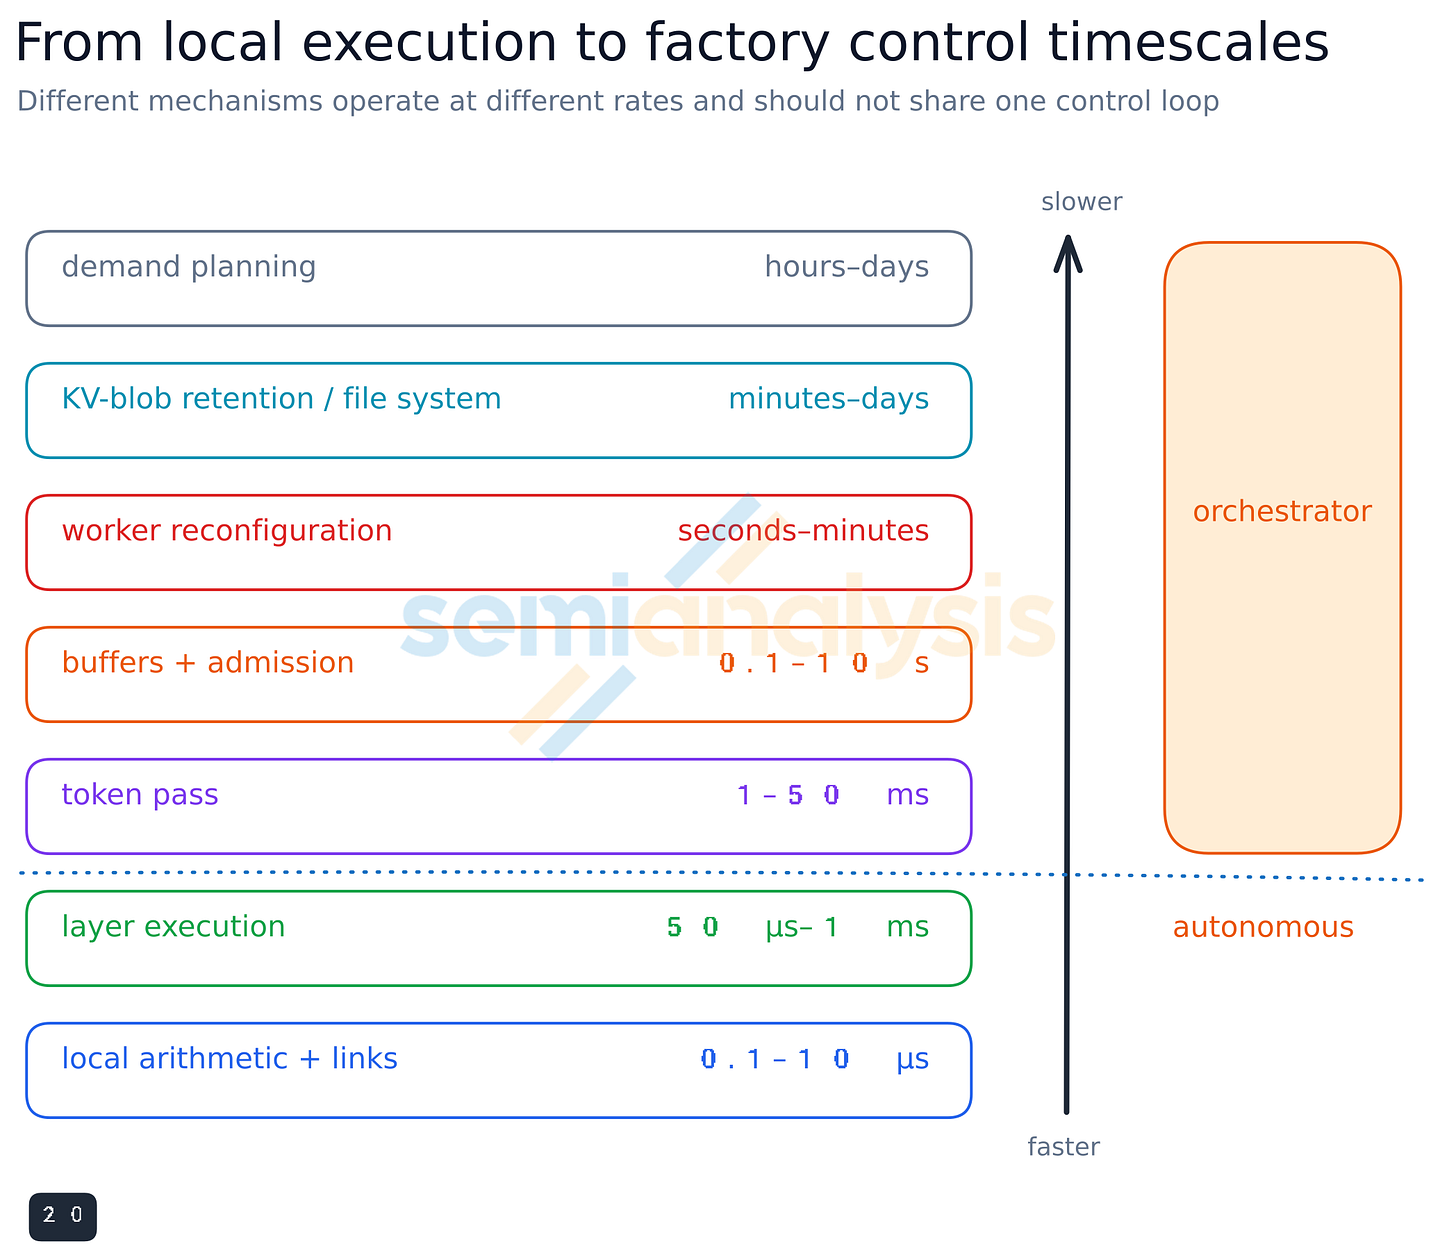
Figure 24. From local execution to factory-control timescales.

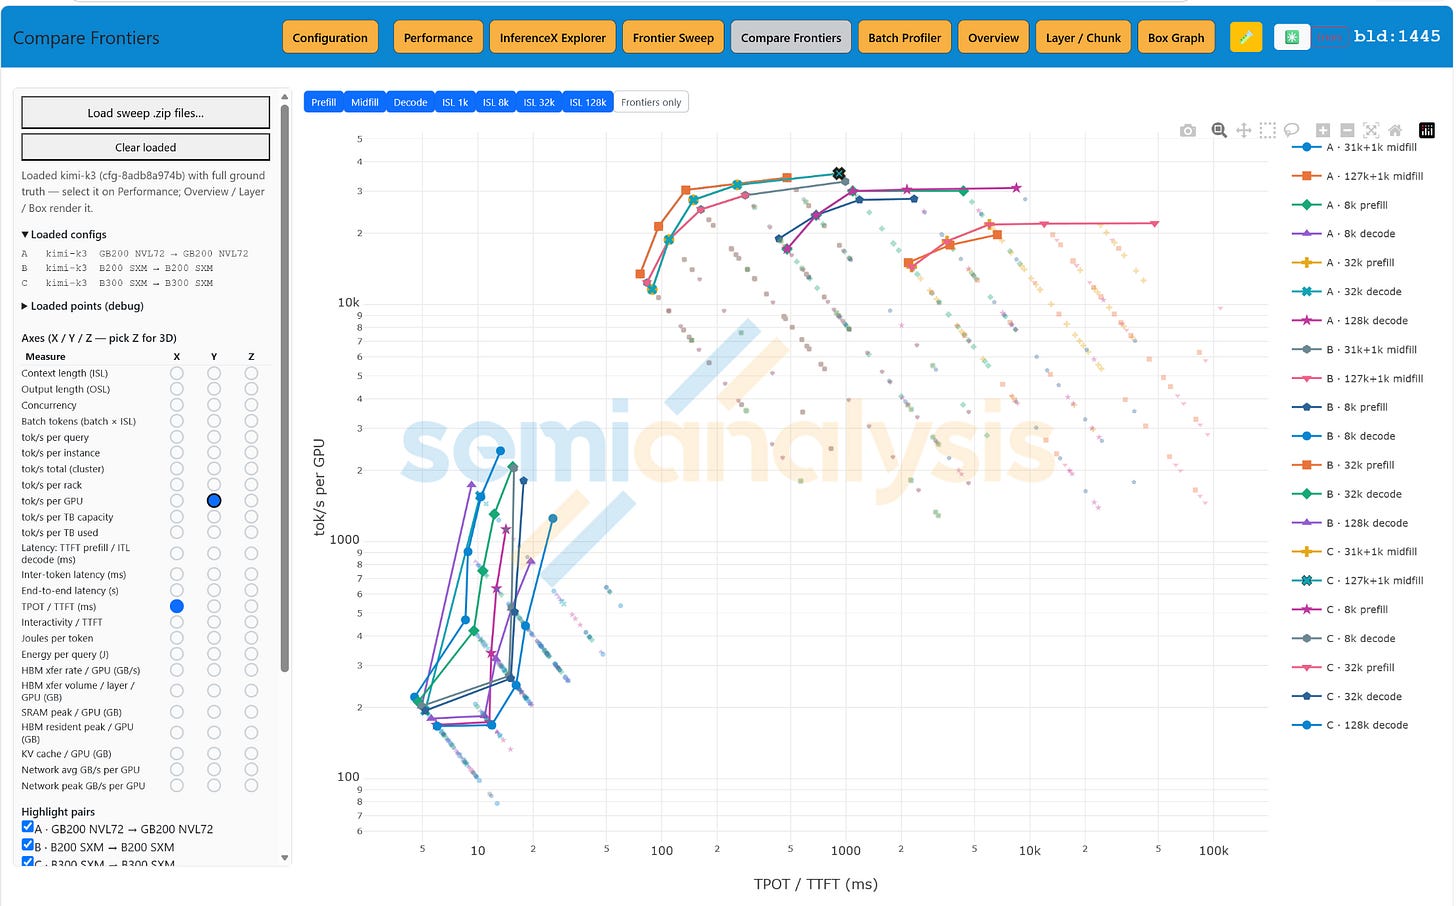
Figure 25. Projected interactivity and throughput frontiers for decode, midfill, and prefill. Source: SemiAnalysis Inference Simulator.

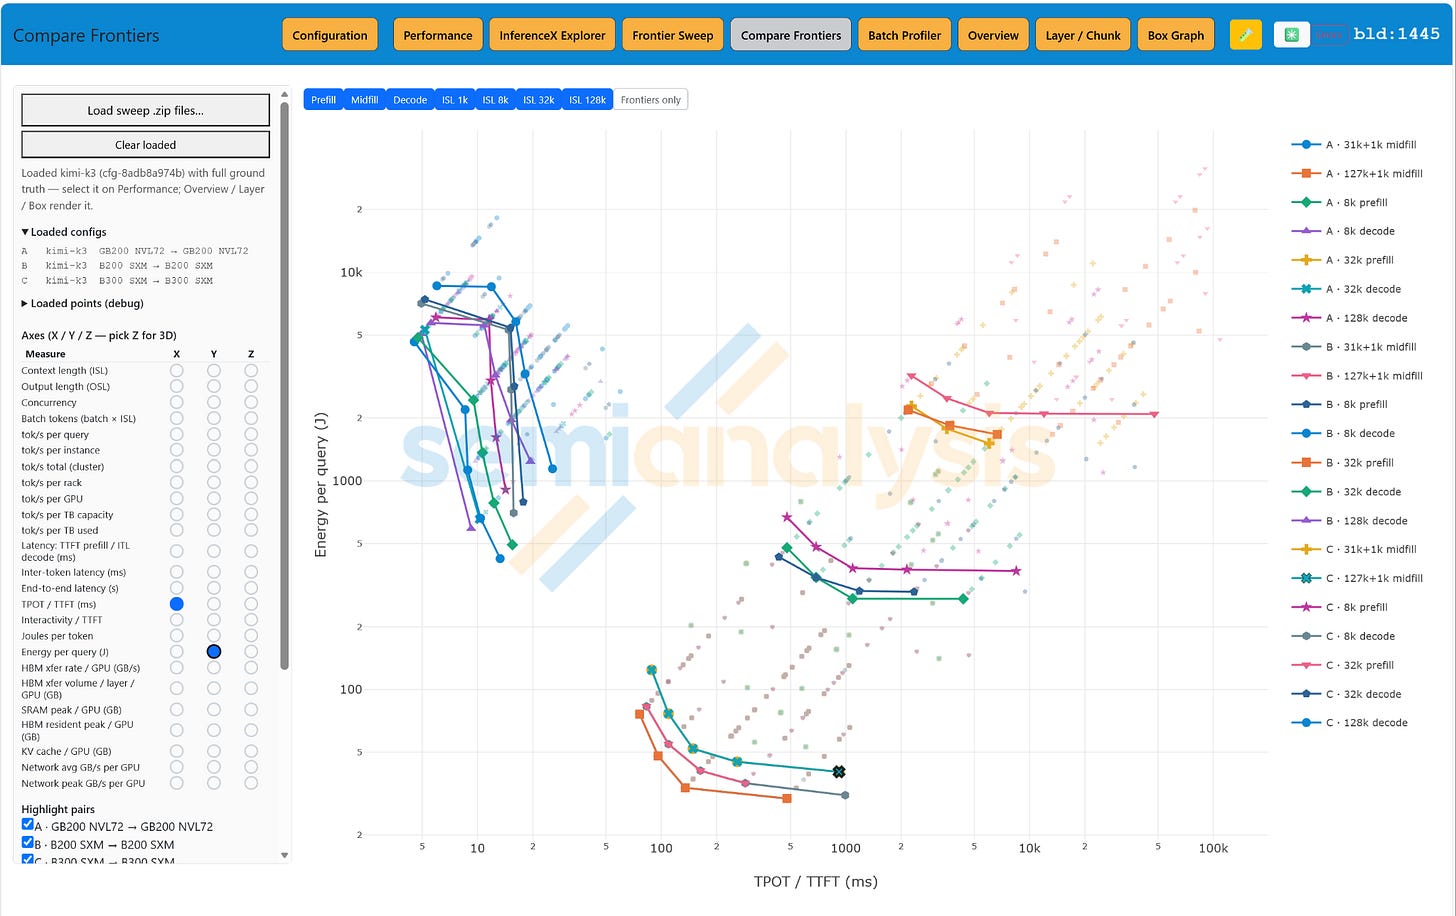
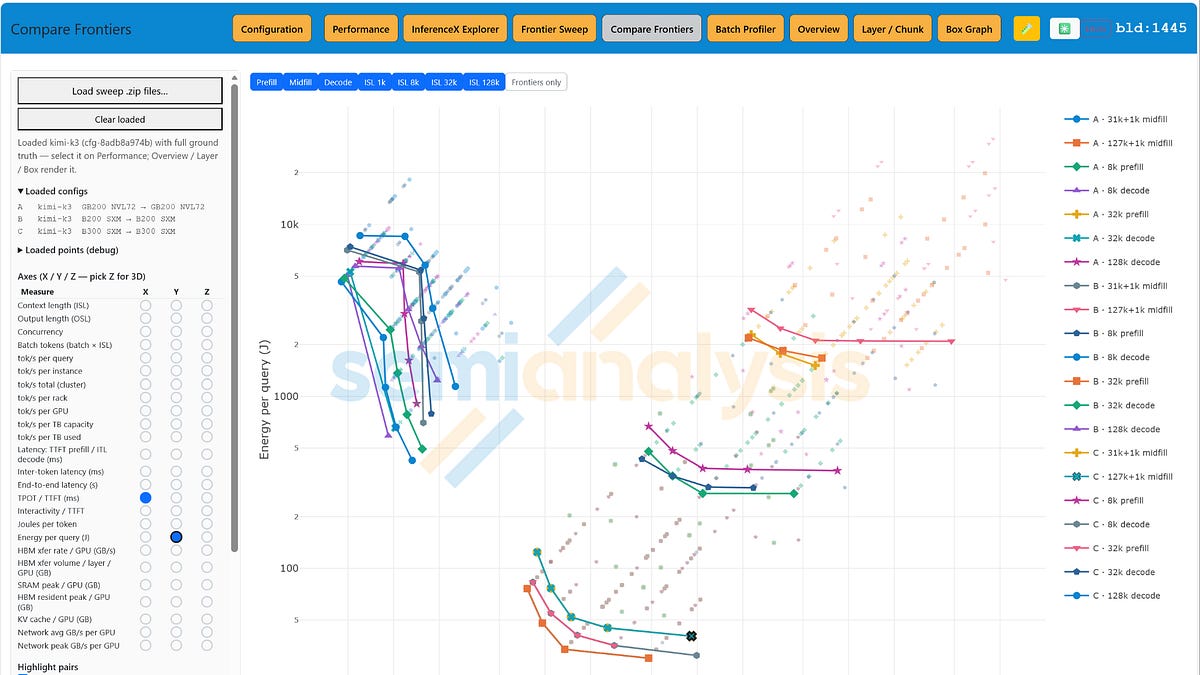
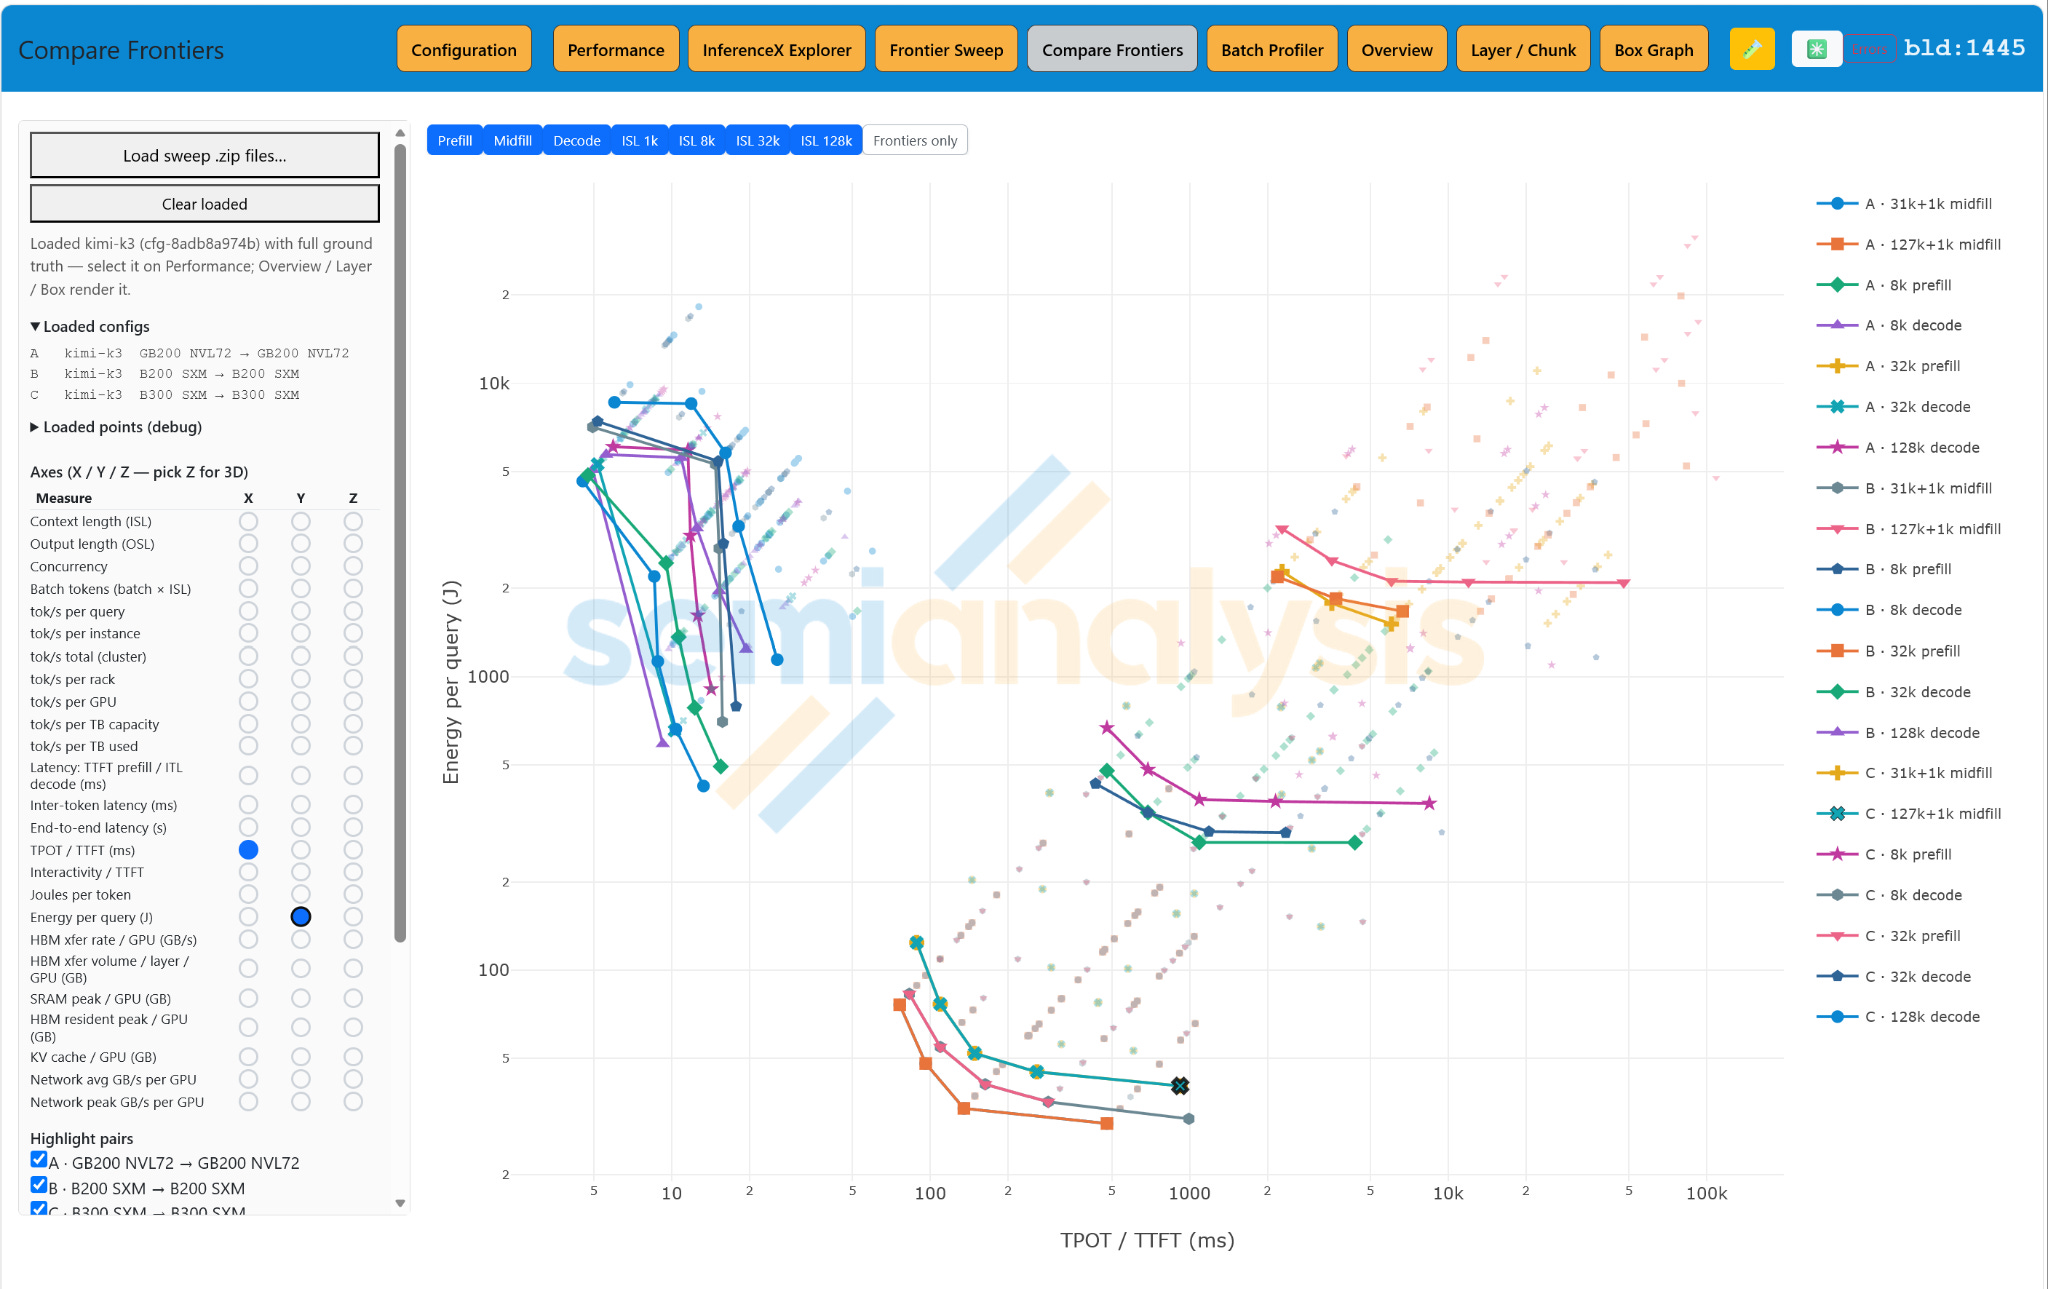
Figure 26. Projected energy per query for the same decode, midfill, and prefill frontiers. Source: SemiAnalysis Inference Simulator.

Figure 27. Projected peak HBM residency per GPU across the simulated frontiers. Source: SemiAnalysis Inference Simulator.

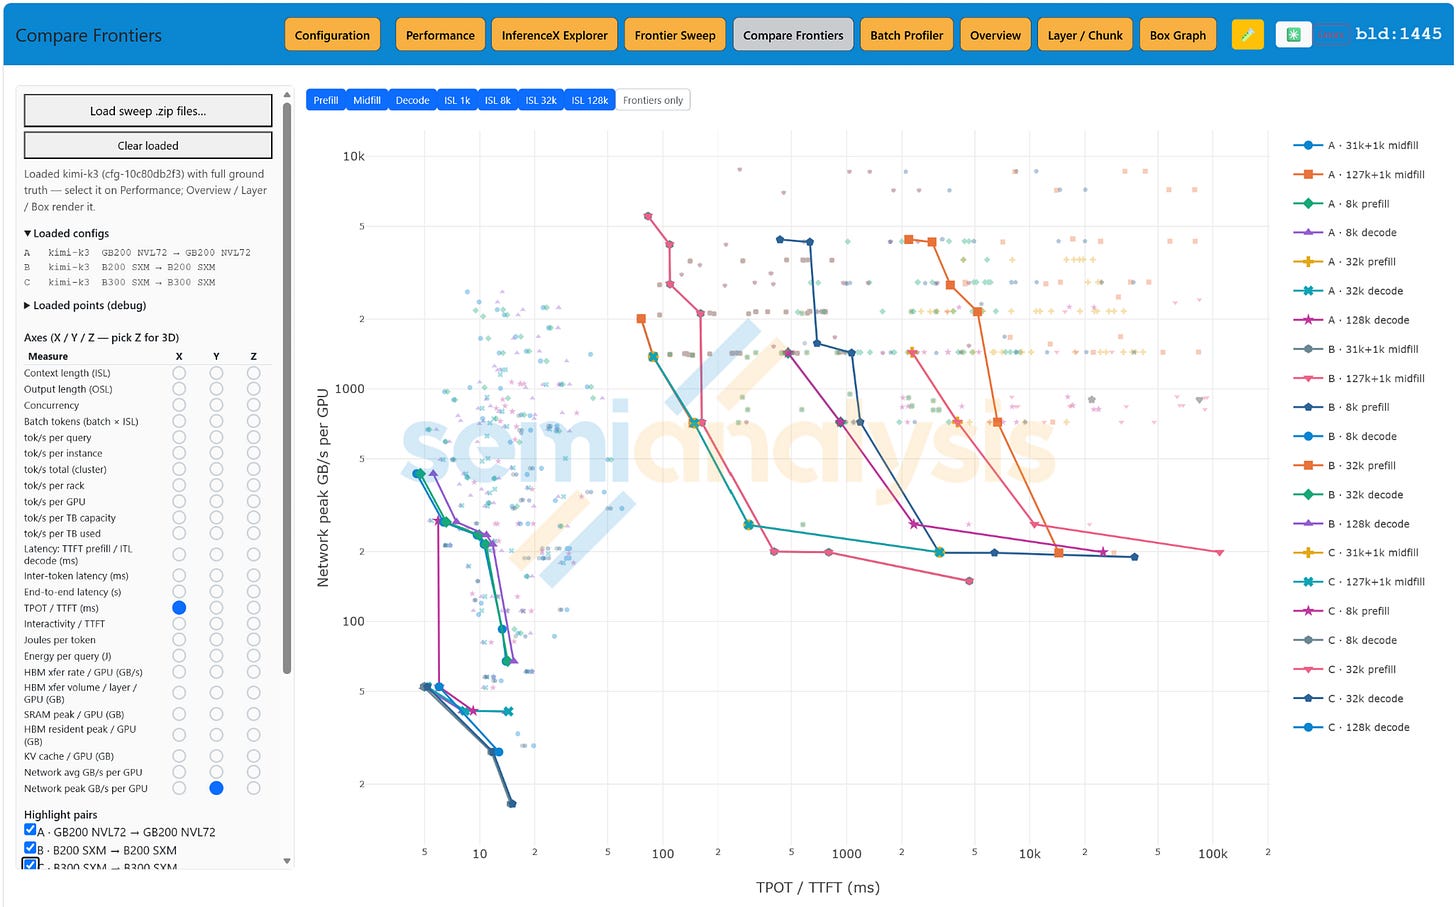
Figure 28. Projected peak network traffic per GPU and the benefit of keeping expert traffic inside the scale-up domain. Source: SemiAnalysis Inference Simulator.

SemiAnalysis

原文链接:https://newsletter.semianalysis.com/p/computation-and-data-movement-for

评论列表
 
 
发表评论

你必须 登录 才能发表评论.

为你推荐